<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="en"><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://gusgkr0117.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://gusgkr0117.github.io/" rel="alternate" type="text/html" hreflang="en" /><updated>2026-09-06T01:18:55+09:00</updated><id>https://gusgkr0117.github.io/feed.xml</id><title type="html">Manbo’s blog</title><subtitle>Hello, welcome to Manbo&apos;s blog
</subtitle><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><entry><title type="html">Complete varieties</title><link href="https://gusgkr0117.github.io/2026/09/06/Complete-variety.html" rel="alternate" type="text/html" title="Complete varieties" /><published>2026-09-06T00:00:00+09:00</published><updated>2026-09-06T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2026/09/06/Complete-variety</id><content type="html" xml:base="https://gusgkr0117.github.io/2026/09/06/Complete-variety.html"><![CDATA[<ul>
  <li>Complete variety의 정의와 직관을 이해한다.</li>
  <li>위상수학에서의 compact 개념과 일치한다.</li>
  <li>실수, 복소수의 완비성 개념과도 유사하다.</li>
</ul>

<!--more-->

<h2 id="complete-variety의-정의">Complete variety의 정의</h2>
<p>어떤 variety $X$에 대해서 다른 모든 variety $Y$에 대해
Projection map $\pi : X\times Y \to Y$가 항상 closed map 이라면,
즉, $X\times Y$의 Zariski closed set $Z$에 대해, image $\pi(Z)$
가 $Y$에서 closed set이라면, $X$를 <strong>Complete</strong> variety라고 한다.</p>

<h2 id="정의에-대한-해석">정의에 대한 해석</h2>
<p>일반적으로 실수나 복소수에서는 metric을 먼저 정의해두고, 해당 metric에 따른 모든 코시 수렴이 (거리가 0에 수렴하는 수열) 항상 동일한 집합안에 존재함을 완비성이라고 한다. 즉, 모든 수열의 수렴값이 항상 같은 집합 내에 존재함을 의미한다.</p>

<p>Metric을 정의할 수 없는 Zariski topology의 경우에 완비성을 정의하려면 universal 한 특성으로 정의하게된다. 즉, 다른 모든 variety와의 관계로 completeness를 정의한다.</p>

<p>완비성의 직관을 생각해보자. 어떤 집합에 완비성을 부여하는 것은 수학의 각 분야에서 다르게 해석될 수 있으나 마치 하나의 직관처럼 느껴진다. 해석학의 완비성은 코시 수열의 비어있는 수렴값을 메우는 작업이다. 대수기하의 완비성은 곡선의 극한 점을 메우는 작업이다. 자연스럽게 있어야할 값을 존재하게 하는 작업이 완비성이다. 그런 의미에서 어떤 Field $K$가 있을 때, $K$를 algebraic closure로 확장하는 작업도 구멍을 메우는 작업이라고 할 수 있겠다.</p>

<p>분야는 다르지만 모두 같은 직관을 가진다. “자연스럽게 존재하는 값을 존재하게 만드는 작업”. 이게 모두 같은 직관이라면 하나의 통합된 정의가 존재할까? 물론, 가능하다. Category theory를 활용하면 통합된 정의를 통해 설명할 수 있다. 하지만 쉬운 과정은 아니여서 여기서는 다루지 않고 추후에 Category theory를 활용한 완비성에 대해 포스팅하도록 하겠다.</p>

<p>여기서 중요한 직관은 Category theory를 통해서 어떤 특성을 정의할 땐, universal한 정의가 항상 사용된다는 것이다. 이러한 universal한 특성은 Complete variety의 정의에서도 볼 수 있다.</p>

<p>어떤 variety $X$의 구멍을 메운다는 것은 $X$에 존재하지 않는 어떤 새로운 공간 $Y$를 덧붙여서 원래는 존재하지 않았던 자명하지 않은 ($V_X \times V_Y$와 같은 형태가 아닌) subvariety가 생긴다는 뜻이다. 예를들면, $X = \mathbb{A}_k^1$일 때, $Y = \mathbb{A}_k^1$이라고 한다면, $X \times Y = \mathbb{A}_{k}^2$이고 그 안에 닫힌 곡선 $xy - 1 = 0$을 생각하면, 이는 projection map에 의해서 닫힌 곡선으로 가지 않는다. 반대로 모든 $Y$에 대해서 항상 새로운 어떤 자명하지 않은 variety가 생성되지 않으면 $X$는 완비성을 갖는다고 말하는건 이제 자연스러워 보인다.</p>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Mathematics" /><summary type="html"><![CDATA[Complete variety의 정의와 직관을 이해한다. 위상수학에서의 compact 개념과 일치한다. 실수, 복소수의 완비성 개념과도 유사하다.]]></summary></entry><entry><title type="html">See-saw principle</title><link href="https://gusgkr0117.github.io/2026/09/02/See-saw-principle.html" rel="alternate" type="text/html" title="See-saw principle" /><published>2026-09-02T00:00:00+09:00</published><updated>2026-09-02T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2026/09/02/See-saw-principle</id><content type="html" xml:base="https://gusgkr0117.github.io/2026/09/02/See-saw-principle.html"><![CDATA[<ul>
  <li>See-saw principle은 theorem of the cube를 증명하는데 사용된다.</li>
</ul>

<h1 id="definitions-and-theorems">Definitions and theorems</h1>
<h2 id="completeness">Completeness</h2>
<p><strong>Complete</strong> algebraic variety $X$는 어떤 variety $Y$에 대해서도
projection morphism</p>

<center>
$
    p : X \times Y \to Y
$
</center>

<p>이 closed set을 closed set으로 보내는 closed map임을 의미한다.</p>

<p>Variety $X$ 위의 rank 1 free sheaf $\mathcal{L}$을 $X$ 위의 line bundle이라고 한다.</p>

<h2 id="cohomology-and-base-change-theorem">Cohomology and base change theorem</h2>
<p>$X$와 $Y$가 scheme이라고 하자. $Y$는 locally Noetherian &amp; reduced scheme이라고 하자.</p>

<p>$f : X \to Y$가 proper한 morphism이라고 하자.</p>

<p>$L$은 $X$위의 coherent sheaf이고, $Y$위에서 flat하다고 하자.</p>

<p>각 $y \in Y$에 대해서 global section들의 dimension</p>

<center>
$
    h^0(y, L) := \mathrm{dim}_{k(y)}H^0(Y_y, L_y)
$
</center>

<p>를 생각할때, 이 값이 항상 $r$로 동일하다면, $f_{\ast}L$은
$Y$위의 locally free sheaf of rank $r$이고, $y \in Y$에 대해
base-change map</p>

<center>
$
    (f_{\ast}L)\otimes_{\mathcal{O}_y} k(y) \to H^0(Y_y, L_y)
$
</center>

<p>는 isomorphism이다.</p>

<h2 id="nakayama-lemma">Nakayama lemma</h2>
<p>$A$를 local ring이라 하고 $\mathfrak{m}$을 $A$의 maximal ideal, $M$을 finitely generated $A$-module이라고 하자.</p>

<center>
$ 
    M/\mathfrak{m} = M
$
</center>

<p>이면, $M = 0$이다.</p>

<p>$A$-module $N,M$에 대해서 어떤 morphism $f: N \to M$이 존재할때,</p>
<center>
$
    f \otimes_A k: N \otimes_A k \to M \otimes_A k
$
</center>
<p>는 surjective라면, cokernel $N/M \otimes_A k = 0$이라는 의미이고,
Nakayama lemma에 의해서 $N/M = 0$이 되어서 $f$는 surjective가 된다.</p>

<h1 id="theorem-1">Theorem 1</h1>

<h2 id="statement">Statement</h2>
<p>$X$와 $Y$가 variety이고, $X$는 complete이라고 하자.
$L$과 $M$을 $X \times Y$위에 있는 line bundle이라고 하자.<br />
<br />
만약에 모든 closed point $y \in Y$에 대해서 restriction $L_y = L |_{X\times \{y\}}$와 $M_y = M|_{X\times \{y\}}$에 대해서, $L_y \cong M_y$라면,<br />
<br />
$Y$위의 어떤 line bundle $N$이 존재해서 $L \otimes M^{-1} \cong p^{\ast}N$을 만족한다. 여기서 $p : X\times Y \to Y$는 projection morphism을 의미하고,
$p^{\ast}$는 pullback을 의미한다. 즉,</p>

<center>
$
    (p^{\ast}N)(U) = \{f\circ p: f \in N(p(U))\} \text{ for an open set } U \subseteq X\times Y.
$
</center>

<h2 id="statement-해석">Statement 해석</h2>
<p>$X \times Y$ 위의 두 line bundle $L$과 $M$에 대해서 $y\in Y$를 매개변수로 봤을 때, local하게는 isomorphic하지만, global하게는 다를때, 우리는 $L$과 $M$이 global하게 어디선가 꼬임의 차이가 있다고 생각할 수 있다.</p>

<p>꼬임에 대한 정보는 $L \otimes M^{-1}$이라는 line bundle에 들어있다.</p>

<p>Variety $X$가 complete일 땐, $Y$위의 line bundle $N$이 존재해서
$ L \otimes M^{-1} \cong p^{\ast}N$가 되어 꼬임에 대한 정보가 온전히 variety $Y$로부터 온다는 것을 의미한다.</p>

<h2 id="proof">Proof</h2>
<p>먼저, $L_y \otimes {M_y}^{-1}$이 trivial line bundle이므로,</p>
<center>
$
    L_y \otimes M_y^{-1} = \mathcal{O}_{X \times \{y\}}
$
</center>
<p>이므로, $L_y \otimes M_y^{-1}$의 global section은 $X \times \{y\}$위의 regular function이 된다. $X$가 complete이므로 $X \times \{y\}$ 도 complete이 되는데, complete variety 위의 regular function은 constant 뿐이므로, $L_y \otimes M_y^{-1}$의 global section은 constant 뿐이다.</p>

<p>$X\times \{y\}$는 $\mathcal{O}_X \otimes_k k(y)$라는 sheaf를 가지므로, 여기서 constant는 residue field $k(y)=\mathcal{O}_{Y,y} / \mathfrak{m}_y$이다.</p>

<p>참고로, $\mathcal{O}_{Y,y}$가 아니라 residue field가 나오는 이유는 $\mathcal{O}_{Y,y}$는 topological 하게 점이 두 개이고 (generic point 와 $\mathfrak{m}_y$), residue field를 사용해야 점이 하나가 되기 때문이다.</p>

<p>$p_{\ast}(L\otimes M^{-1})$는 $Y$위의 sheaf로써 다음과 같이 정의한다.</p>

<center>
$
    p_{\ast}(L \otimes M^{-1})(U) = \Gamma(X \times U, L \otimes M^{-1}).
$
</center>

<p>$p$는 flat하고, $X$는 complete해서 $p$는 proper이고, $L \otimes M^{-1}$은 locally free이므로 coherent하며, $H^0(X_y, L_y\otimes M_y^{-1})$는 locally constant이므로, <strong>cohomology and base change</strong> 정리에 의해서
$p_{\ast}(L \otimes M^{-1})$은 rank 1 locally free sheaf, 즉, line bundle이다. 이를 $Y$위의 line bundle $N$이라고 표기하자. 이제 다음을 보이면 충분하다.</p>

<center>
$
    p^{\ast}N \cong L \otimes M^{-1}.
$
</center>

<p>$y\in Y$에 대한 fiber를 생각하면, 아래와 같은 cartesian diagram을 먼저 그리고,</p>

<center>
$
    \begin{array}{ccc}
    X \times \{y\} &amp; \xrightarrow{\ i_y\ } &amp; X \times Y \\
    {\scriptstyle p_y}\downarrow &amp; &amp; \downarrow{\scriptstyle p} \\
    \mathrm{Spec}(k(y)) &amp; \xrightarrow{\ j_y\ } &amp; Y
    \end{array}
$
</center>

<p>이 cartesian diagram에 의해서 아래 수식을 얻는다.</p>

<center>
 $
 (p^{\ast}N)_y = i_y^{\ast}p^{\ast}N = p_y^{\ast}j_y^{\ast}N = p_y^{\ast}(N \otimes_k k(y)) = \mathcal{O}_{X_y} \otimes_{k(y)} (N\otimes_k k(y)) \cong \mathcal{O}_{X_y} \otimes_{k(y)} H^0(X_y, L_y \otimes M_y^{-1})
 $
</center>

<p>마지막 isomorphism은 <strong>cohomology and base change</strong>정리로부터 얻는다.
statement의 가정 $L_y \cong M_y$에 의해서 $L_y \otimes M_y^{-1} \cong \mathcal{O}_{X_y}$를 얻는다. 따라서, $(p^{\ast}N)_y \cong (L \otimes M^{-1})_y$ for all $y \in Y$ 이다.</p>

<p>$p^{\ast}N, L\otimes M^{-1}$ 둘 다 locally free rank 1라는 사실과 <strong>Nakayama lemma</strong>에 의해서 $p^{\ast}N \cong L\otimes M^{-1}$이다.</p>

<h1 id="see-saw-principle">See-saw principle</h1>
<h2 id="statement-1">Statement</h2>
<p>$X$와 $Y$가 variety이고, $X$는 complete이라고 하자.
$L$과 $M$을 $X \times Y$위에 있는 line bundle이라고 하자.<br />
<br />
만약에 모든 closed point $y \in Y$에 대해서 restriction $L_y = L |_{X\times \{y\}}$와 $M_y = M|_{X\times \{y\}}$에 대해서, $L_y \cong M_y$이고,<br />
<br />
어떤 $x \in X$에 대해서 $L_x \cong M_x$라면, $L \cong M$이다.</p>
<h2 id="proof-1">Proof</h2>
<p>Theorem 1에 의해서 $Y$위의 line bundle $N$이 존재해서 $L \otimes M^{-1} \cong p^*{\ast}N$이다. $X = x$에 대한 fiber를 생각하면,
$L_x \otimes M_x^{-1} \cong (p^{\ast}N)_x$이다. 문제 조건에 의해서 $L_x \otimes M_x^{-1} = \mathcal{O}_{\{x\}\otimes Y}\cong (p^{\ast}N)_x$이므로 $N = \mathcal{O}_Y$이고,
$L \cong M$이다.</p>

<h1 id="references">References</h1>
<ul>
  <li><a href="https://www.math.ru.nl/~bmoonen/BookAV/LineBund.pdf">Moonen - Abelian Variety</a></li>
</ul>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Mathematics" /><category term="Abelian_Variety" /><summary type="html"><![CDATA[See-saw principle은 theorem of the cube를 증명하는데 사용된다. Definitions and theorems Completeness Complete algebraic variety $X$는 어떤 variety $Y$에 대해서도 projection morphism $ p : X \times Y \to Y $ 이 closed set을 closed set으로 보내는 closed map임을 의미한다. Variety $X$ 위의 rank 1 free sheaf $\mathcal{L}$을 $X$ 위의 line bundle이라고 한다. Cohomology and base change theorem $X$와 $Y$가 scheme이라고 하자. $Y$는 locally Noetherian &amp; reduced scheme이라고 하자. $f : X \to Y$가 proper한 morphism이라고 하자. $L$은 $X$위의 coherent sheaf이고, $Y$위에서 flat하다고 하자. 각 $y \in Y$에 대해서 global section들의 dimension $ h^0(y, L) := \mathrm{dim}_{k(y)}H^0(Y_y, L_y) $ 를 생각할때, 이 값이 항상 $r$로 동일하다면, $f_{\ast}L$은 $Y$위의 locally free sheaf of rank $r$이고, $y \in Y$에 대해 base-change map $ (f_{\ast}L)\otimes_{\mathcal{O}_y} k(y) \to H^0(Y_y, L_y) $ 는 isomorphism이다. Nakayama lemma $A$를 local ring이라 하고 $\mathfrak{m}$을 $A$의 maximal ideal, $M$을 finitely generated $A$-module이라고 하자. $ M/\mathfrak{m} = M $ 이면, $M = 0$이다. $A$-module $N,M$에 대해서 어떤 morphism $f: N \to M$이 존재할때, $ f \otimes_A k: N \otimes_A k \to M \otimes_A k $ 는 surjective라면, cokernel $N/M \otimes_A k = 0$이라는 의미이고, Nakayama lemma에 의해서 $N/M = 0$이 되어서 $f$는 surjective가 된다. Theorem 1 Statement $X$와 $Y$가 variety이고, $X$는 complete이라고 하자. $L$과 $M$을 $X \times Y$위에 있는 line bundle이라고 하자. 만약에 모든 closed point $y \in Y$에 대해서 restriction $L_y = L |_{X\times \{y\}}$와 $M_y = M|_{X\times \{y\}}$에 대해서, $L_y \cong M_y$라면, $Y$위의 어떤 line bundle $N$이 존재해서 $L \otimes M^{-1} \cong p^{\ast}N$을 만족한다. 여기서 $p : X\times Y \to Y$는 projection morphism을 의미하고, $p^{\ast}$는 pullback을 의미한다. 즉, $ (p^{\ast}N)(U) = \{f\circ p: f \in N(p(U))\} \text{ for an open set } U \subseteq X\times Y. $ Statement 해석 $X \times Y$ 위의 두 line bundle $L$과 $M$에 대해서 $y\in Y$를 매개변수로 봤을 때, local하게는 isomorphic하지만, global하게는 다를때, 우리는 $L$과 $M$이 global하게 어디선가 꼬임의 차이가 있다고 생각할 수 있다. 꼬임에 대한 정보는 $L \otimes M^{-1}$이라는 line bundle에 들어있다. Variety $X$가 complete일 땐, $Y$위의 line bundle $N$이 존재해서 $ L \otimes M^{-1} \cong p^{\ast}N$가 되어 꼬임에 대한 정보가 온전히 variety $Y$로부터 온다는 것을 의미한다. Proof 먼저, $L_y \otimes {M_y}^{-1}$이 trivial line bundle이므로, $ L_y \otimes M_y^{-1} = \mathcal{O}_{X \times \{y\}} $ 이므로, $L_y \otimes M_y^{-1}$의 global section은 $X \times \{y\}$위의 regular function이 된다. $X$가 complete이므로 $X \times \{y\}$ 도 complete이 되는데, complete variety 위의 regular function은 constant 뿐이므로, $L_y \otimes M_y^{-1}$의 global section은 constant 뿐이다. $X\times \{y\}$는 $\mathcal{O}_X \otimes_k k(y)$라는 sheaf를 가지므로, 여기서 constant는 residue field $k(y)=\mathcal{O}_{Y,y} / \mathfrak{m}_y$이다. 참고로, $\mathcal{O}_{Y,y}$가 아니라 residue field가 나오는 이유는 $\mathcal{O}_{Y,y}$는 topological 하게 점이 두 개이고 (generic point 와 $\mathfrak{m}_y$), residue field를 사용해야 점이 하나가 되기 때문이다. $p_{\ast}(L\otimes M^{-1})$는 $Y$위의 sheaf로써 다음과 같이 정의한다. $ p_{\ast}(L \otimes M^{-1})(U) = \Gamma(X \times U, L \otimes M^{-1}). $ $p$는 flat하고, $X$는 complete해서 $p$는 proper이고, $L \otimes M^{-1}$은 locally free이므로 coherent하며, $H^0(X_y, L_y\otimes M_y^{-1})$는 locally constant이므로, cohomology and base change 정리에 의해서 $p_{\ast}(L \otimes M^{-1})$은 rank 1 locally free sheaf, 즉, line bundle이다. 이를 $Y$위의 line bundle $N$이라고 표기하자. 이제 다음을 보이면 충분하다. $ p^{\ast}N \cong L \otimes M^{-1}. $ $y\in Y$에 대한 fiber를 생각하면, 아래와 같은 cartesian diagram을 먼저 그리고, $ \begin{array}{ccc} X \times \{y\} &amp; \xrightarrow{\ i_y\ } &amp; X \times Y \\ {\scriptstyle p_y}\downarrow &amp; &amp; \downarrow{\scriptstyle p} \\ \mathrm{Spec}(k(y)) &amp; \xrightarrow{\ j_y\ } &amp; Y \end{array} $ 이 cartesian diagram에 의해서 아래 수식을 얻는다. $ (p^{\ast}N)_y = i_y^{\ast}p^{\ast}N = p_y^{\ast}j_y^{\ast}N = p_y^{\ast}(N \otimes_k k(y)) = \mathcal{O}_{X_y} \otimes_{k(y)} (N\otimes_k k(y)) \cong \mathcal{O}_{X_y} \otimes_{k(y)} H^0(X_y, L_y \otimes M_y^{-1}) $ 마지막 isomorphism은 cohomology and base change정리로부터 얻는다. statement의 가정 $L_y \cong M_y$에 의해서 $L_y \otimes M_y^{-1} \cong \mathcal{O}_{X_y}$를 얻는다. 따라서, $(p^{\ast}N)_y \cong (L \otimes M^{-1})_y$ for all $y \in Y$ 이다. $p^{\ast}N, L\otimes M^{-1}$ 둘 다 locally free rank 1라는 사실과 Nakayama lemma에 의해서 $p^{\ast}N \cong L\otimes M^{-1}$이다. See-saw principle Statement $X$와 $Y$가 variety이고, $X$는 complete이라고 하자. $L$과 $M$을 $X \times Y$위에 있는 line bundle이라고 하자. 만약에 모든 closed point $y \in Y$에 대해서 restriction $L_y = L |_{X\times \{y\}}$와 $M_y = M|_{X\times \{y\}}$에 대해서, $L_y \cong M_y$이고, 어떤 $x \in X$에 대해서 $L_x \cong M_x$라면, $L \cong M$이다. Proof Theorem 1에 의해서 $Y$위의 line bundle $N$이 존재해서 $L \otimes M^{-1} \cong p^*{\ast}N$이다. $X = x$에 대한 fiber를 생각하면, $L_x \otimes M_x^{-1} \cong (p^{\ast}N)_x$이다. 문제 조건에 의해서 $L_x \otimes M_x^{-1} = \mathcal{O}_{\{x\}\otimes Y}\cong (p^{\ast}N)_x$이므로 $N = \mathcal{O}_Y$이고, $L \cong M$이다. References Moonen - Abelian Variety]]></summary></entry><entry><title type="html">Yoneda Lemma</title><link href="https://gusgkr0117.github.io/2026/08/27/Yoneda-Lemma.html" rel="alternate" type="text/html" title="Yoneda Lemma" /><published>2026-08-27T00:00:00+09:00</published><updated>2026-08-27T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2026/08/27/Yoneda-Lemma</id><content type="html" xml:base="https://gusgkr0117.github.io/2026/08/27/Yoneda-Lemma.html"><![CDATA[<ul>
  <li>Yoneda Lemma는 어떤 object $X$에 대해서, 같은 category 안에 있는 모든 object로부터 출발해서 해당 object $X$로 가는 모든 morphism은
해당 object에 대한 정보를 완벽하게 담고있음을 증명한다.</li>
  <li>Formal하게 category의 object $A$는 Functor $\mathrm{Mor}(*, A)$에 의해 결정된다.</li>
</ul>

<!--more-->

<h1 id="statement-of-yoneda-lemma">Statement of Yoneda Lemma</h1>
<p>$\mathcal{C}$를 어떤 category라고 하자. $X$를 $\mathcal{C}$ 안의 object라고 하자.</p>

<p>Functor $h_X: \mathcal{C} \to \mathrm{Sets}$는 다음과 같이 정의한다.</p>

<center>
$
    h_X(A) = \mathrm{Mor}(A, X)
$
</center>

<p>그리고</p>

<center>
$
    h_X(f : A \to B) : \mathrm{Mor}(B, X) \to \mathrm{Mor}(A, B), g \mapsto g \circ f
$
</center>

<p>를 만족한다.</p>

<p>Functor $h_X$는 $X$를 up to isomorphism으로 unique하게 결정한다.</p>

<h1 id="proof-of-yoneda-lemma">Proof of Yoneda Lemma</h1>

<p>(a) Category $\mathcal{C}$ 안에서 어떤 object $X’$를 선택해서 functor $h_{X’}$을 생각하자.</p>

<p>두 functor $h_X$와 $h_{X’}$ 사이에 natural transformation $\eta$를 생각하자. 그러면 아래 diagram을 commutative하게 만든다.</p>

<center>
$
    \begin{array}{ccc}
    \mathrm{Mor}(B, X) &amp; \xrightarrow{\ h_X(f)\ } &amp; \mathrm{Mor}(A, X) \\
    {\scriptstyle \eta_B}\downarrow &amp; &amp; \downarrow{\scriptstyle \eta_A} \\
    \mathrm{Mor}(B, X') &amp; \xrightarrow{\ h_{X'}(f)\ } &amp; \mathrm{Mor}(A, X')
    \end{array}
$
</center>

<p>이 commutative diagram은 모든 object $A,B$와 morphism $f : A \to B$에 대해 성립한다.</p>

<p>$B = X$일 때, 왼쪽 위의 object는 $\mathrm{Mor}(X, X)$가 되며, 이 set에서 identity morphism $\mathrm{id}_X$를 선택할 수 있다.</p>

<p>위의 commutative diagram에 의해서 $\eta_X(\mathrm{id}_X) \circ f = \eta_A(\mathrm{id}_X \circ f) = \eta_A(f)$를 만족한다.
따라서 우리는 모든 object $A$와 morphism $f : A \to X$에 대하여</p>

<center>
$
    \eta_A(f) = \eta_X(\mathrm{id}_X) \circ f
$
</center>

<p>관계를 얻는다.</p>

<p>(b) 만약 $h_X$와 $h_{X’}$이 natural isomorphism이라면, 즉, $\eta_A$가 모든 $A$에 대해 bijection이라면,</p>

<p>$A = X’$ 일 때, $\eta_{X’}(f) = \eta_X(\mathrm{id}_X) \circ f$ for $f : X’ \to X$이고,</p>

<p>$\eta_{X’}(f) = \mathrm{id}_{X’} = \eta_X(\mathrm{id}_X) \circ f$인 $f$가 존재한다.</p>

<p>따라서, $f: X’ \to X$는 isomorphism이고, $X’$과 $X$는 isomorphic하다.</p>

<p>이것으로 Yoneda Lemma가 증명된다.</p>

<h1 id="universal-property와-관계">Universal Property와 관계</h1>
<p>Category theory에서 initial object, final object, zero object, product, tensor product, fiber product, localization 과 같이
새로운 object를 만드는 과정은 universal property를 활용한다.</p>

<p>Universal property는 “새로운 object와 모든 object들과의 관계”를 정의함으로써 새로운 object를 up to unique isomorphism으로 유일하게
결정되도록 생성한다.</p>

<p>이런 현상이 일어나는 이유는 Yoneda Lemma로부터 알 수 있다. 어떤 object는 사실 모든 object와 해당 object와의 관계로 완벽하게 표현된다.
따라서 universal property는 Yoneda Lemma를 이해하면 자연스러운 과정으로 느껴진다.</p>

<h1 id="references">References</h1>
<ul>
  <li><a href="https://math.stanford.edu/~vakil/216blog/">Ravi Vakil, MATH 216: Foundations of Algebraic Geometry, 2024</a>, p.42</li>
</ul>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Mathematics" /><category term="Category_Theory" /><summary type="html"><![CDATA[Yoneda Lemma는 어떤 object $X$에 대해서, 같은 category 안에 있는 모든 object로부터 출발해서 해당 object $X$로 가는 모든 morphism은 해당 object에 대한 정보를 완벽하게 담고있음을 증명한다. Formal하게 category의 object $A$는 Functor $\mathrm{Mor}(*, A)$에 의해 결정된다.]]></summary></entry><entry><title type="html">Freelancer Experiences 2</title><link href="https://gusgkr0117.github.io/2025/01/26/Freelancer-Works-2.html" rel="alternate" type="text/html" title="Freelancer Experiences 2" /><published>2025-01-26T00:00:00+09:00</published><updated>2025-01-26T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2025/01/26/Freelancer-Works-2</id><content type="html" xml:base="https://gusgkr0117.github.io/2025/01/26/Freelancer-Works-2.html"><![CDATA[<ul>
  <li>운도 좋았고 만족도가 가장 높았던 프리랜서 세번째 과제</li>
  <li>threshold ECDSA와 <a href="https://internetcomputer.org/">Internet Computer</a></li>
  <li>Reference : <a href="https://eprint.iacr.org/2022/506">Design and analysis of a distributed ECDSA signing service</a></li>
</ul>

<h1 id="우유니에서-만난-세번째-클라이언트">우유니에서 만난 세번째 클라이언트</h1>
<p>로스앤잴레스에서 두번째 클라이언트와 작업을 마치고 우리는 남미여행을 시작했다. 남미의 첫 여행지는 멕시코의 칸쿤이었다. 칸쿤은 신혼여행지로 많이 꼽히는 휴양지인데 미국서부 여행은 차를 타고 오랜시간 이동해야했던 터라 힘들거라고 예상해서 쉬어가는 장소로 넣은 계획이었다(매우 현명한 생각이었다.). 남미에서 처음에 칸쿤(멕시코)-이카(페루)-쿠스코(페루)-코파카바나(볼리비아)-우유니(볼리비아) 까지 일정이 3주 정도 잡혀있었다. 일이 끊기고 우유니에서 일이 다시 들어오기까지 거의 3주가량 걸린 것이다. 이때 당시에 나는 갑자기 수입이 끊긴터라 굉장히 불안한 심정이었다. 하지만 일을 하는 것은 부차적인 수입을 위해 하는 것이고 그것 때문에 여행기분을 망치고 싶지 않아서 애써 불안감을 떨쳐냈다. 여행하기 전부터 일을 제대로 시작해보려고 맘먹고 한 것이 아니고 그냥 한번 해보자는 생각으로 했던건데 그래도 수입이 있다가 다시 없어지니 오히려 불안감이 생겼더랬다.</p>

<p>마음을 다잡고 여행에 집중하면서 내 시간과 페이스를 찾기 위해서 나는 논문을 읽고자했다. 근데 마침 두번째 과제를 수행하는 중에 연락이 왔었던 클라이언트가 있었고, 해당 클라이언트가 제안한 논문이 threshold ECDSA를 블록체인에서 구현한 논문이었어서 나로써는 굉장히 흥미가 이끌렸고 이 논문을 그냥 읽어보기로했다. 그러니까 사실은 클라이언트와 같이 일을 하려고 논문을 읽은게 아니라 내가 관심이 생겨서 읽게 된 것이다.</p>

<p>논문을 읽고나서 보니 그제서야 클라이언트가 가진 의문을 나도 갖게되었고, 진심으로 클라이언트가 그 문제를 해결했는지 순수하게 궁금해졌다. 메시지를 보내서 질문을 했더니 아직 해결못했더랬다. 재밌는건 이때부터였다. 그 때 나랑 와이프는 우유니에 있었고, 밖이 겨울처럼 추웠어서 숙소에 난로를 켜두고 이불이 겹겹이 덮여있는 침대 위에서 쉬고 있었다. 나는 클라이언트에게 논문을 읽고난 내 생각을 전달했고, 클라이언트는 깜짝 놀랬다. 아직 계약을 시작도 안했는데 알아서 논문 읽고 혼자 연구하고 있었으니 클라이언트 입장에서는 너무 고마운(?) 일을 하게 된 것이다. 그런 나의 행동이 클라이언트에게 굉장한 호감을 사서 그날 계약을 하게 되었다. 무려 시급 30달러로 시작한 일이었다. 그 이후 시급은 조금 더 올라서 40달러까지도 받았다.</p>

<h1 id="internet-computer의-threshold-ecdsa">Internet Computer의 Threshold ECDSA</h1>
<p>클라이언트가 요구한 과제는 Internet Computer의 Jens Groth와 Victor Shoup이 개발한 분산화된 비동기적인 시스템 환경에서 사용할 수 있는 threshold ECDSA 기법을 더 빠르게 최적화하는 것이었다. 클라이언트가 논문을 읽었을 때 궁금했던 것은 threshold ECDSA 기법에서 bottleneck인 Multi-Party Computation(MPC) 중에서도 shared secret끼리 곱셈하는 부분을 없애도 괜찮은가 그리고 실제 코드 상에서 이 부분을 삭제해서 구현할 수 있는가 였다. 나도 똑같은 의문을 갖기 시작했다. Shamir secret sharing 방법을 기반으로 MPC를 실행하는데 서명 값을 계산하는 과정에서 왜 랜덤값을 곱하는지 당시에는 의문이 들었다. 랜덤값이 불필요한 것처럼 보였다. 그래서 클라이언트의 말대로 랜덤 값을 사용하지 않는 버전으로 코드를 수정해주었다. 코드를 수정하는데 대략 2주 조금 안걸렸던 것으로 기억하는데 한주당 20시간~30시간 사이로 일했으니 꽤 많이 벌었다.</p>

<h1 id="안전성-검증을-위한-계약-연장">안전성 검증을 위한 계약 연장</h1>
<p>코드를 수정해서 클라이언트가 원하는대로 돌아가는 것을 보여주었더니 클라이언트의 나에대한 신뢰도는 더 급격히 상승했다. 급여는 40달러로 올랐고, 클라이언트는 추가로 암호 기법을 개발하는데 참여해달라고 요구했다. 난 당연히 승낙했다. 그런데 한가지 찝찝한 점은 랜덤 값을 곱하는 부분을 빼도 과연 안전성에 영향이 없을까 하는 것이었다. Victor Shoup 교수는 나도 알정도로 암호분야에서 유명한 분인데 쓸모없이 그것을 넣지는 않았을 것 같았다. 나는 단순히 랜덤값이 존재하는 이유는 Byzantine Fault Tolerance(BFT) 조건을 만족시키기 위한 것이라고 생각했고(클라이언트가 처음에 그렇게 이해하고 나한테 설명했었다.), 클라이언트가 서명 기법을 사용하는 환경은 블록체인 네트워크가 아니기 때문에 제외해도 된다고 생각했던 것이다. 사실 이 부분은 애초에 클라이언트가 구현을 먼저 부탁했었기에 안전성에 어떤 영향을 주는지 크게 생각해보지 않았었다.</p>

<p>나는 클라이언트에게 내가 다음 해야할 일에 관해 제안을 했다. 우리가 아직 안전성 검증을 제대로 해본적이 없으니 내가 논문을 더 꼼꼼히 읽어보고 안전성에 어떤 영향이 있는지 더 구체적으로 분석해보겠다고 했다. 그랬더니 당연히 클라이언트는 흔쾌히 승낙했다. 안전성이야 말로 그들의 사업에 있어서 굉장히 중요한 요소니까 당연히 중요한 일이었다.</p>

<p>재밌는 것은 내가 클라이언트에게 안전성 검증을 위해서 다른 기업에게 돈을 주고 부탁한적이 있느냐고 물었더니 당연히 있다고 했다. 안전성 분석 리포트를 받아보니 왠걸 소스코드에 대한 단순 취약점 분석을 해놓은 것이었다. 심지어 가장 critical하다고 판단된 취약점은 랜덤 seed를 deterministic하게 생성하는 것 정도였다(아니 이건 누가봐도 테스트 과정에서 생긴 실수잖아..). 안전성 분석을 맡긴 그 기업에게 엄청난 돈을 주었을 것으로 예상하는데 내가 본 리포트는 대학생들도 쓸 수 있을 것 같았다.</p>

<p>그러니 안전성 분석이라는 이 일은 나는 돈도 많이 벌면서 내가 좋아하는 일해서 좋고, 클라이언트는 적은 돈으로 진심을 다해 검증해주는 박사에 준하는(?) 전문인력이 생겨서 좋은 일이 된 것이다. 지금 생각해봐도 프리랜서 일을 하면서 가장 만족도가 높았던 일이었다.</p>

<p>그렇게 기분이 좋을때 나와 와이프는 아르헨티나의 살타에 있었다. 살타는 짧은 시간동안 머물렀지만 아직도 나와 와이프에게 너무 좋은 기억으로 남아있다. 살타의 물가는 정말 미치도록 싸서 엠파나다 하나가 천원이 안했다. 엠파나다 몇개씩 먹어도 배부르게 너무 싼 가격에 잘 먹었고, 단돈 몇만원으로 미친듯이 맛있는 스테이크 집에 가서 스테이크와 와인을 먹었는데 너무 행복하게 먹었던 기억이 있다. 그날 아침에는 카페에 가서 나는 프리랜서 일을 만족스럽게 하고 있었고, 돈을 벌어 뿌듯하였으며 먹는 것도 너무 행복해서 좋은 기억으로 남아있다.</p>

<h1 id="랜덤값을-곱하는-것은-masking을-위한-것">랜덤값을 곱하는 것은 Masking을 위한 것</h1>
<p>논문을 봐도 안전성에 어떤 영향이 있는지 바로 보이진 않았다. 그래서 안전성 증명을 해놓은 파트를 중점적으로 읽었는데, 이들이 안전성 증명을 한 공격 모델이 Universal Composability Framework(UC framework)였다. 간략히 설명하면 분산 환경이 아닌 다른 환경에서도 공격자를 대상으로 똑같이 simulation할 수 있는지를 증명하는 것이었다. 그리고 그 증명에 랜덤값을 곱한 것이 사용되었다. 즉, 기법 자체에서는 랜덤값을 곱했다가 다시 나눠서 없애는게 아무런 의미가 없는 것처럼 보여도 안전성 증명에서는 사용되고 있었던 것이다. 지금 당장 공격방법이 생각나지 않더라도 해당 논문의 안전성 증명이 수정된 기법에서는 적용되지 않기 때문에 랜덤값이 빠진 수정된 기법이 안전하지 않거나 새로운 안전성 증명을 만들어야한다는게 내 생각이었다.</p>

<p>고심끝에 내린 결론은 랜덤값을 사용하지 않으면 안전하지 않다는 것이었다. 랜덤값은 threshold 기법에서 다른 참여자에게 나의 비밀값을 노출시키지 않기 위해 마스킹 역할로 사용한 것이기 때문에 이게 없어지면 내 랜덤값이 노출된 다는 것이고 이는 당연히 안전하지 않은 것이었다. 이러한 사실을 발견하고 난 뒤에는 마스킹 없이 진행했을 때 각자 shared secret이 노출되므로 안전하지 않은 것이 당연하게 보였다. 그 전까지 왜 이런 당연한 사실을 발견하지 못했는지 조금은 스스로가 아직 실력이 부족하다고 느껴졌던 것 같다.</p>

<p>그럼에도 불구하고 당연히 나는 돈벌어서 좋고 배운게 있어서 좋아서 일석이조로 만족스러웠다. 이 모든걸 알고보니 내가 마치 미리 안전성에 문제가 있다는 사실을 알고 숨겨서 더 많은 돈을 빼먹은 악당처럼 보일 수도 있겠으나, 믿거나 말거나 나는 최대한 빠른시간내에 정직하게 과제를 수행하고자 노력했다는 것을 알아주면 좋겠다.</p>

<p>Universal Composability Framework에 관심이 있다면 <a href="https://eprint.iacr.org/2000/067">Ran Canetti의 논문</a>을 읽어보면 좋겠다. 2001년에 제시된 개념이라 꽤 오래전부터 존재했던 모델임을 알아두자.</p>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Freelancer" /><category term="Upwork" /><summary type="html"><![CDATA[운도 좋았고 만족도가 가장 높았던 프리랜서 세번째 과제 threshold ECDSA와 Internet Computer Reference : Design and analysis of a distributed ECDSA signing service 우유니에서 만난 세번째 클라이언트 로스앤잴레스에서 두번째 클라이언트와 작업을 마치고 우리는 남미여행을 시작했다. 남미의 첫 여행지는 멕시코의 칸쿤이었다. 칸쿤은 신혼여행지로 많이 꼽히는 휴양지인데 미국서부 여행은 차를 타고 오랜시간 이동해야했던 터라 힘들거라고 예상해서 쉬어가는 장소로 넣은 계획이었다(매우 현명한 생각이었다.). 남미에서 처음에 칸쿤(멕시코)-이카(페루)-쿠스코(페루)-코파카바나(볼리비아)-우유니(볼리비아) 까지 일정이 3주 정도 잡혀있었다. 일이 끊기고 우유니에서 일이 다시 들어오기까지 거의 3주가량 걸린 것이다. 이때 당시에 나는 갑자기 수입이 끊긴터라 굉장히 불안한 심정이었다. 하지만 일을 하는 것은 부차적인 수입을 위해 하는 것이고 그것 때문에 여행기분을 망치고 싶지 않아서 애써 불안감을 떨쳐냈다. 여행하기 전부터 일을 제대로 시작해보려고 맘먹고 한 것이 아니고 그냥 한번 해보자는 생각으로 했던건데 그래도 수입이 있다가 다시 없어지니 오히려 불안감이 생겼더랬다. 마음을 다잡고 여행에 집중하면서 내 시간과 페이스를 찾기 위해서 나는 논문을 읽고자했다. 근데 마침 두번째 과제를 수행하는 중에 연락이 왔었던 클라이언트가 있었고, 해당 클라이언트가 제안한 논문이 threshold ECDSA를 블록체인에서 구현한 논문이었어서 나로써는 굉장히 흥미가 이끌렸고 이 논문을 그냥 읽어보기로했다. 그러니까 사실은 클라이언트와 같이 일을 하려고 논문을 읽은게 아니라 내가 관심이 생겨서 읽게 된 것이다. 논문을 읽고나서 보니 그제서야 클라이언트가 가진 의문을 나도 갖게되었고, 진심으로 클라이언트가 그 문제를 해결했는지 순수하게 궁금해졌다. 메시지를 보내서 질문을 했더니 아직 해결못했더랬다. 재밌는건 이때부터였다. 그 때 나랑 와이프는 우유니에 있었고, 밖이 겨울처럼 추웠어서 숙소에 난로를 켜두고 이불이 겹겹이 덮여있는 침대 위에서 쉬고 있었다. 나는 클라이언트에게 논문을 읽고난 내 생각을 전달했고, 클라이언트는 깜짝 놀랬다. 아직 계약을 시작도 안했는데 알아서 논문 읽고 혼자 연구하고 있었으니 클라이언트 입장에서는 너무 고마운(?) 일을 하게 된 것이다. 그런 나의 행동이 클라이언트에게 굉장한 호감을 사서 그날 계약을 하게 되었다. 무려 시급 30달러로 시작한 일이었다. 그 이후 시급은 조금 더 올라서 40달러까지도 받았다. Internet Computer의 Threshold ECDSA 클라이언트가 요구한 과제는 Internet Computer의 Jens Groth와 Victor Shoup이 개발한 분산화된 비동기적인 시스템 환경에서 사용할 수 있는 threshold ECDSA 기법을 더 빠르게 최적화하는 것이었다. 클라이언트가 논문을 읽었을 때 궁금했던 것은 threshold ECDSA 기법에서 bottleneck인 Multi-Party Computation(MPC) 중에서도 shared secret끼리 곱셈하는 부분을 없애도 괜찮은가 그리고 실제 코드 상에서 이 부분을 삭제해서 구현할 수 있는가 였다. 나도 똑같은 의문을 갖기 시작했다. Shamir secret sharing 방법을 기반으로 MPC를 실행하는데 서명 값을 계산하는 과정에서 왜 랜덤값을 곱하는지 당시에는 의문이 들었다. 랜덤값이 불필요한 것처럼 보였다. 그래서 클라이언트의 말대로 랜덤 값을 사용하지 않는 버전으로 코드를 수정해주었다. 코드를 수정하는데 대략 2주 조금 안걸렸던 것으로 기억하는데 한주당 20시간~30시간 사이로 일했으니 꽤 많이 벌었다. 안전성 검증을 위한 계약 연장 코드를 수정해서 클라이언트가 원하는대로 돌아가는 것을 보여주었더니 클라이언트의 나에대한 신뢰도는 더 급격히 상승했다. 급여는 40달러로 올랐고, 클라이언트는 추가로 암호 기법을 개발하는데 참여해달라고 요구했다. 난 당연히 승낙했다. 그런데 한가지 찝찝한 점은 랜덤 값을 곱하는 부분을 빼도 과연 안전성에 영향이 없을까 하는 것이었다. Victor Shoup 교수는 나도 알정도로 암호분야에서 유명한 분인데 쓸모없이 그것을 넣지는 않았을 것 같았다. 나는 단순히 랜덤값이 존재하는 이유는 Byzantine Fault Tolerance(BFT) 조건을 만족시키기 위한 것이라고 생각했고(클라이언트가 처음에 그렇게 이해하고 나한테 설명했었다.), 클라이언트가 서명 기법을 사용하는 환경은 블록체인 네트워크가 아니기 때문에 제외해도 된다고 생각했던 것이다. 사실 이 부분은 애초에 클라이언트가 구현을 먼저 부탁했었기에 안전성에 어떤 영향을 주는지 크게 생각해보지 않았었다. 나는 클라이언트에게 내가 다음 해야할 일에 관해 제안을 했다. 우리가 아직 안전성 검증을 제대로 해본적이 없으니 내가 논문을 더 꼼꼼히 읽어보고 안전성에 어떤 영향이 있는지 더 구체적으로 분석해보겠다고 했다. 그랬더니 당연히 클라이언트는 흔쾌히 승낙했다. 안전성이야 말로 그들의 사업에 있어서 굉장히 중요한 요소니까 당연히 중요한 일이었다. 재밌는 것은 내가 클라이언트에게 안전성 검증을 위해서 다른 기업에게 돈을 주고 부탁한적이 있느냐고 물었더니 당연히 있다고 했다. 안전성 분석 리포트를 받아보니 왠걸 소스코드에 대한 단순 취약점 분석을 해놓은 것이었다. 심지어 가장 critical하다고 판단된 취약점은 랜덤 seed를 deterministic하게 생성하는 것 정도였다(아니 이건 누가봐도 테스트 과정에서 생긴 실수잖아..). 안전성 분석을 맡긴 그 기업에게 엄청난 돈을 주었을 것으로 예상하는데 내가 본 리포트는 대학생들도 쓸 수 있을 것 같았다. 그러니 안전성 분석이라는 이 일은 나는 돈도 많이 벌면서 내가 좋아하는 일해서 좋고, 클라이언트는 적은 돈으로 진심을 다해 검증해주는 박사에 준하는(?) 전문인력이 생겨서 좋은 일이 된 것이다. 지금 생각해봐도 프리랜서 일을 하면서 가장 만족도가 높았던 일이었다. 그렇게 기분이 좋을때 나와 와이프는 아르헨티나의 살타에 있었다. 살타는 짧은 시간동안 머물렀지만 아직도 나와 와이프에게 너무 좋은 기억으로 남아있다. 살타의 물가는 정말 미치도록 싸서 엠파나다 하나가 천원이 안했다. 엠파나다 몇개씩 먹어도 배부르게 너무 싼 가격에 잘 먹었고, 단돈 몇만원으로 미친듯이 맛있는 스테이크 집에 가서 스테이크와 와인을 먹었는데 너무 행복하게 먹었던 기억이 있다. 그날 아침에는 카페에 가서 나는 프리랜서 일을 만족스럽게 하고 있었고, 돈을 벌어 뿌듯하였으며 먹는 것도 너무 행복해서 좋은 기억으로 남아있다. 랜덤값을 곱하는 것은 Masking을 위한 것 논문을 봐도 안전성에 어떤 영향이 있는지 바로 보이진 않았다. 그래서 안전성 증명을 해놓은 파트를 중점적으로 읽었는데, 이들이 안전성 증명을 한 공격 모델이 Universal Composability Framework(UC framework)였다. 간략히 설명하면 분산 환경이 아닌 다른 환경에서도 공격자를 대상으로 똑같이 simulation할 수 있는지를 증명하는 것이었다. 그리고 그 증명에 랜덤값을 곱한 것이 사용되었다. 즉, 기법 자체에서는 랜덤값을 곱했다가 다시 나눠서 없애는게 아무런 의미가 없는 것처럼 보여도 안전성 증명에서는 사용되고 있었던 것이다. 지금 당장 공격방법이 생각나지 않더라도 해당 논문의 안전성 증명이 수정된 기법에서는 적용되지 않기 때문에 랜덤값이 빠진 수정된 기법이 안전하지 않거나 새로운 안전성 증명을 만들어야한다는게 내 생각이었다. 고심끝에 내린 결론은 랜덤값을 사용하지 않으면 안전하지 않다는 것이었다. 랜덤값은 threshold 기법에서 다른 참여자에게 나의 비밀값을 노출시키지 않기 위해 마스킹 역할로 사용한 것이기 때문에 이게 없어지면 내 랜덤값이 노출된 다는 것이고 이는 당연히 안전하지 않은 것이었다. 이러한 사실을 발견하고 난 뒤에는 마스킹 없이 진행했을 때 각자 shared secret이 노출되므로 안전하지 않은 것이 당연하게 보였다. 그 전까지 왜 이런 당연한 사실을 발견하지 못했는지 조금은 스스로가 아직 실력이 부족하다고 느껴졌던 것 같다. 그럼에도 불구하고 당연히 나는 돈벌어서 좋고 배운게 있어서 좋아서 일석이조로 만족스러웠다. 이 모든걸 알고보니 내가 마치 미리 안전성에 문제가 있다는 사실을 알고 숨겨서 더 많은 돈을 빼먹은 악당처럼 보일 수도 있겠으나, 믿거나 말거나 나는 최대한 빠른시간내에 정직하게 과제를 수행하고자 노력했다는 것을 알아주면 좋겠다. Universal Composability Framework에 관심이 있다면 Ran Canetti의 논문을 읽어보면 좋겠다. 2001년에 제시된 개념이라 꽤 오래전부터 존재했던 모델임을 알아두자.]]></summary></entry><entry><title type="html">Freelancer Experiences 1</title><link href="https://gusgkr0117.github.io/2024/10/25/Freelancer-Works-1.html" rel="alternate" type="text/html" title="Freelancer Experiences 1" /><published>2024-10-25T00:00:00+09:00</published><updated>2024-10-25T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2024/10/25/Freelancer-Works-1</id><content type="html" xml:base="https://gusgkr0117.github.io/2024/10/25/Freelancer-Works-1.html"><![CDATA[<ul>
  <li>5개월간 개발자 프리랜서로 일하면서 느낀 장단점</li>
  <li>업무분야 : 최신 암호기술(e.g. tECDSA) 분석 및 자문, 블록체인 기술(e.g. ZK coprocessor) 적용 및 최적화, 윈도우/자바스크립트 리버싱, C/C++/Rust 최적화, 게임 개발 등</li>
</ul>

<h1 id="프리랜서로-일하게-된-계기">프리랜서로 일하게 된 계기?</h1>
<p>1년 전부터 와이프가 대략 5개월 간의 장기간 여행 프로젝트를 계획했다. 나와 와이프가 직장을 퇴직하고, 다른 일을 시작하기 전에 다녀오기 위해서였다. 많은 고민끝에 나는 이런 여행을 할 수 있는 기회는 젊을 때 흔치 않기 때문에 같이 다녀오기로 했다. 여행하면서 생길만한 크고작은 사건사고에 대해서도 걱정이 있었지만, 나는 그것보다도 돈과 미래에 대한 불안감이 사실 더 컸던 것 같다. 와이프와 대화를 나누면서 한동안 유투브를 통해 보고 들었던 디지털노마드처럼 살아보는게 어떨까 하는 생각이 들었고, 그때부터 적절한 프리랜서 플랫폼을 찾기 시작하면서 업워크를 선택하게 되었다.</p>

<p>프리랜서로의 경험은 전무하기 때문에 일단 테스트 삼아서 여행가기 한달쯤 전부터 업워크 계정과 프로필을 만들고, 아주 작은 일이라도 한번 해보고 싶었다. 프로필을 완성한다고해서 일이 바로 들어오지는 않았다. 내 경우에는 일주일 정도 지나서 $30짜리 작은 일이 들어왔던 것 같다. 그것이 프리랜서로서 첫 시작이었다.</p>

<h1 id="운이-좋았다">운이 좋았다?</h1>
<p>처음으로 내게 연락한 고객은 터키에 사는 남자였다. 비트코인 트랜잭션을 분석해서 트랜잭션 서명이 어떻게 이루어지는지 직접 구현해가며 알려달라는 것이었다. 고객은 나에게 비트코인 트랜잭션을 파싱하는 파이썬 샘플코드를 공유해주었고, 그것이 잘 동작하도록 만들어달라고 요청했다. 돈보다는 일단 작은 일이라도 한번 해보자는 마음으로 시작했으며, 심지어 일도 재밌어보여서 적극적으로 도와줬다. 당연히 대화는 모두 영어로 했지만 기술적, 비즈니스적인 대화라서 오히려 일상대화보다 하기 쉽게 느껴졌다. 지금도 기억나는 것은 고객이 비트코인의 Segwit 서명 기술을 이해하지 못해서 내가 잘 설명해주었고 일은 원만히 잘 마무리되었다.</p>

<p>두번째 일은 여행가기 직전 2주 전쯤에 들어왔던 것 같다. 두번째 고객은 호주에 사는 블록체인 스타트업 개발자였다. 이번에는 시간당 $10로 일을 시작했다. 지금 생각해보면 엄청 적은 금액이었지만 나는 여전히 아주 적게 받더라도 일을 하는 경험을 쌓아보는게 중요하다고 생각했다. 이 스타트업은 블록체인에서 요즘 뜨는 기술은 Zero-Knowledge 기술을 이용해서 ZK coprocessor를 만드는 일을 하고 있었다. <a href="https://internetcomputer.org/">Internet Computer</a>라는 최신 블록체인 네트워크에서 스마트 컨트랙트를 만들고 ZK coprocessor를 활용해 off-chain에서 작업한 데이터를 on-chain으로 올려주는 서비스였다. 두번째 일 역시도 너무 관심있고, 재미있는 분야였다. 심지어 Zero-knowledge 기술을 내가 직접 만져보고, 적용해볼 수 있다는 점에서 나에게 정말 좋은 경험이었다. 이 개발자는 기존에 나와있는 <a href="https://github.com/risc0/risc0">ZKSnark/ZKStark 기술</a>을 활용해서 off-chain에서 일어난 <a href="https://docs.tlsnotary.org/">notary TLS</a> 인증을 on-chain에서 증명하고 싶어했고, TLS 인증 과정이 너무 복잡해서 Proof의 크기가 너무 커지는 문제를 해결하고 싶어했다. 나는 notary TLS 인증과정에서 사용된 hash commitment의 크기가 너무 커서 쓸데없이 proof의 크기를 증가시킨다고 판단해 commitment를 proof에서 제외시키면 문제가 해결될 것이라고 제안했고, 이를 적용한 결과 굉장히 작은 proof와 빠른 verification을 얻을 수 있었다. 이를통해 2주만에 이번 고객은 시급을 두배인 $20로 올려주었다.</p>

<p>두번째 고객과 일을 같이하면서 사용한 협업 툴은 <a href="https://marketplace.visualstudio.com/items?itemName=Serhioromano.vscode-gitflow">Git(Git Flow)</a>, <a href="https://www.notion.so/">Notion</a>, <a href="https://linear.app/">Linear</a> 였다. 모두 잘 사용해보지 않던 것들이라서 정말 좋은 경험이 되었다고 생각한다. Linear의 경우 온라인 협업관리에 정말 괜찮은 툴이라고 느껴졌고, Git Flow, Notion은 혼자 연구하고 개발할 때도 아직 유용하게 잘 사용하고 있다.</p>

<p>두번째 일은 대략 두달 조금 안되는 기간동안 했던 것 같다. 해당 일을 통해 처음부터 운좋게 꽤 많은 돈을 벌 수 있었다. 참고로 클라이언트와 계약/면접을 시작할 땐 솔직하게 자신의 상황을 말하는 것이 좋다. 나의 경우 Zoom으로 면접을 봤는데 내가 현재 장기간 여행을 다니고 있고, timezone이 자주 변할 수 있으며, 파트타임(주 20~30hrs)으로만 일할 수 있다고 말했다. 여행다닌다는 것이 안좋게 보일까봐 걱정했는데, 오히려 더 좋게 봐주는 것을보고 놀랐다. 심지어는 해당 스타트업에 나처럼 온라인으로 일하는 사람이 대부분이었고, 그들은 모두 각기 다른 나라에서 다른 timezone에서 일하고 있었다.</p>

<p>두번째 일은 생각보다 깔끔하게 마무리하지는 못했다. 내가 처음 최적화했던 코드는 Rust기반 영지식 코드였는데 해당 task가 끝난 이후에 Internet Computer기반 스마트 컨트랙트(Rust 기반)를 다루는 일을 시켰다. 그때 하필 내가 미국서부를 여행하면서 렌트카를 타고 캐니언들을 보고 다닐때라서 인터넷을 할 기회가 마땅하지 않았고, 업무의 연속성을 유지하기가 어려웠던 것 같다. 클라이언트도 나의 상황을 알고 일이 지지부진해지는 것을 느꼈고, 결국 여행끝나고 다시보자는 말로 계약이 마무리되었다. 계약이 끝날때 나는 로스앤잴레스 숙소에서 Zoom으로 대화를 나누었다.</p>

<h1 id="프리랜서의-숙명인가">프리랜서의 숙명인가</h1>
<p>나는 고정된 월급을 받는 일만 해왔었고, 프리랜서로 일을 하다가 갑자기 일이 끊기는 경우를 처음 경험했다. 두번째 일은 그런 의미에서 또 새로운 경험이었다. 갑자기 수입이 끊기는 경험은 아직 익숙하지 않아서 약간의 불안감이 몰려왔다. 나는 아직 멘탈이 강하지 않았기에 돈을 벌때는 좋아라 하다가도 일이 끊기고나니 프리랜서는 역시 할게 못되나보다 라고 생각했다. 하지만 지금와서 보면 그렇지도 않다. 수입이 불규칙한 것은 프리랜서 뿐만 아니라 모든 자영업이 그럴 것이다. 그리고 또 하다보면 초연해지기도 한다. 자유롭고, 하고싶은 일을 골라할 수 있다는 점에서 장점도 있기 때문에 내가 감수해야할 단점도 존재하는 것이다. 그것이 프리랜서의 숙명이니까. 주기적인 월급을 받는 것도 좋지만 불규칙한 수입 속에서 멘탈잡고 일을 계속해 나아가는 것도 나쁘지 않은 경험이다. 그래야 프리랜서로 살면서 쉽게 돈버는 환상을 깨고, 나에게 맞는 더 현명한 선택을 할 수 있을테니까.</p>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Freelancer" /><category term="Upwork" /><summary type="html"><![CDATA[5개월간 개발자 프리랜서로 일하면서 느낀 장단점 업무분야 : 최신 암호기술(e.g. tECDSA) 분석 및 자문, 블록체인 기술(e.g. ZK coprocessor) 적용 및 최적화, 윈도우/자바스크립트 리버싱, C/C++/Rust 최적화, 게임 개발 등 프리랜서로 일하게 된 계기? 1년 전부터 와이프가 대략 5개월 간의 장기간 여행 프로젝트를 계획했다. 나와 와이프가 직장을 퇴직하고, 다른 일을 시작하기 전에 다녀오기 위해서였다. 많은 고민끝에 나는 이런 여행을 할 수 있는 기회는 젊을 때 흔치 않기 때문에 같이 다녀오기로 했다. 여행하면서 생길만한 크고작은 사건사고에 대해서도 걱정이 있었지만, 나는 그것보다도 돈과 미래에 대한 불안감이 사실 더 컸던 것 같다. 와이프와 대화를 나누면서 한동안 유투브를 통해 보고 들었던 디지털노마드처럼 살아보는게 어떨까 하는 생각이 들었고, 그때부터 적절한 프리랜서 플랫폼을 찾기 시작하면서 업워크를 선택하게 되었다. 프리랜서로의 경험은 전무하기 때문에 일단 테스트 삼아서 여행가기 한달쯤 전부터 업워크 계정과 프로필을 만들고, 아주 작은 일이라도 한번 해보고 싶었다. 프로필을 완성한다고해서 일이 바로 들어오지는 않았다. 내 경우에는 일주일 정도 지나서 $30짜리 작은 일이 들어왔던 것 같다. 그것이 프리랜서로서 첫 시작이었다. 운이 좋았다? 처음으로 내게 연락한 고객은 터키에 사는 남자였다. 비트코인 트랜잭션을 분석해서 트랜잭션 서명이 어떻게 이루어지는지 직접 구현해가며 알려달라는 것이었다. 고객은 나에게 비트코인 트랜잭션을 파싱하는 파이썬 샘플코드를 공유해주었고, 그것이 잘 동작하도록 만들어달라고 요청했다. 돈보다는 일단 작은 일이라도 한번 해보자는 마음으로 시작했으며, 심지어 일도 재밌어보여서 적극적으로 도와줬다. 당연히 대화는 모두 영어로 했지만 기술적, 비즈니스적인 대화라서 오히려 일상대화보다 하기 쉽게 느껴졌다. 지금도 기억나는 것은 고객이 비트코인의 Segwit 서명 기술을 이해하지 못해서 내가 잘 설명해주었고 일은 원만히 잘 마무리되었다. 두번째 일은 여행가기 직전 2주 전쯤에 들어왔던 것 같다. 두번째 고객은 호주에 사는 블록체인 스타트업 개발자였다. 이번에는 시간당 $10로 일을 시작했다. 지금 생각해보면 엄청 적은 금액이었지만 나는 여전히 아주 적게 받더라도 일을 하는 경험을 쌓아보는게 중요하다고 생각했다. 이 스타트업은 블록체인에서 요즘 뜨는 기술은 Zero-Knowledge 기술을 이용해서 ZK coprocessor를 만드는 일을 하고 있었다. Internet Computer라는 최신 블록체인 네트워크에서 스마트 컨트랙트를 만들고 ZK coprocessor를 활용해 off-chain에서 작업한 데이터를 on-chain으로 올려주는 서비스였다. 두번째 일 역시도 너무 관심있고, 재미있는 분야였다. 심지어 Zero-knowledge 기술을 내가 직접 만져보고, 적용해볼 수 있다는 점에서 나에게 정말 좋은 경험이었다. 이 개발자는 기존에 나와있는 ZKSnark/ZKStark 기술을 활용해서 off-chain에서 일어난 notary TLS 인증을 on-chain에서 증명하고 싶어했고, TLS 인증 과정이 너무 복잡해서 Proof의 크기가 너무 커지는 문제를 해결하고 싶어했다. 나는 notary TLS 인증과정에서 사용된 hash commitment의 크기가 너무 커서 쓸데없이 proof의 크기를 증가시킨다고 판단해 commitment를 proof에서 제외시키면 문제가 해결될 것이라고 제안했고, 이를 적용한 결과 굉장히 작은 proof와 빠른 verification을 얻을 수 있었다. 이를통해 2주만에 이번 고객은 시급을 두배인 $20로 올려주었다. 두번째 고객과 일을 같이하면서 사용한 협업 툴은 Git(Git Flow), Notion, Linear 였다. 모두 잘 사용해보지 않던 것들이라서 정말 좋은 경험이 되었다고 생각한다. Linear의 경우 온라인 협업관리에 정말 괜찮은 툴이라고 느껴졌고, Git Flow, Notion은 혼자 연구하고 개발할 때도 아직 유용하게 잘 사용하고 있다. 두번째 일은 대략 두달 조금 안되는 기간동안 했던 것 같다. 해당 일을 통해 처음부터 운좋게 꽤 많은 돈을 벌 수 있었다. 참고로 클라이언트와 계약/면접을 시작할 땐 솔직하게 자신의 상황을 말하는 것이 좋다. 나의 경우 Zoom으로 면접을 봤는데 내가 현재 장기간 여행을 다니고 있고, timezone이 자주 변할 수 있으며, 파트타임(주 20~30hrs)으로만 일할 수 있다고 말했다. 여행다닌다는 것이 안좋게 보일까봐 걱정했는데, 오히려 더 좋게 봐주는 것을보고 놀랐다. 심지어는 해당 스타트업에 나처럼 온라인으로 일하는 사람이 대부분이었고, 그들은 모두 각기 다른 나라에서 다른 timezone에서 일하고 있었다. 두번째 일은 생각보다 깔끔하게 마무리하지는 못했다. 내가 처음 최적화했던 코드는 Rust기반 영지식 코드였는데 해당 task가 끝난 이후에 Internet Computer기반 스마트 컨트랙트(Rust 기반)를 다루는 일을 시켰다. 그때 하필 내가 미국서부를 여행하면서 렌트카를 타고 캐니언들을 보고 다닐때라서 인터넷을 할 기회가 마땅하지 않았고, 업무의 연속성을 유지하기가 어려웠던 것 같다. 클라이언트도 나의 상황을 알고 일이 지지부진해지는 것을 느꼈고, 결국 여행끝나고 다시보자는 말로 계약이 마무리되었다. 계약이 끝날때 나는 로스앤잴레스 숙소에서 Zoom으로 대화를 나누었다. 프리랜서의 숙명인가 나는 고정된 월급을 받는 일만 해왔었고, 프리랜서로 일을 하다가 갑자기 일이 끊기는 경우를 처음 경험했다. 두번째 일은 그런 의미에서 또 새로운 경험이었다. 갑자기 수입이 끊기는 경험은 아직 익숙하지 않아서 약간의 불안감이 몰려왔다. 나는 아직 멘탈이 강하지 않았기에 돈을 벌때는 좋아라 하다가도 일이 끊기고나니 프리랜서는 역시 할게 못되나보다 라고 생각했다. 하지만 지금와서 보면 그렇지도 않다. 수입이 불규칙한 것은 프리랜서 뿐만 아니라 모든 자영업이 그럴 것이다. 그리고 또 하다보면 초연해지기도 한다. 자유롭고, 하고싶은 일을 골라할 수 있다는 점에서 장점도 있기 때문에 내가 감수해야할 단점도 존재하는 것이다. 그것이 프리랜서의 숙명이니까. 주기적인 월급을 받는 것도 좋지만 불규칙한 수입 속에서 멘탈잡고 일을 계속해 나아가는 것도 나쁘지 않은 경험이다. 그래야 프리랜서로 살면서 쉽게 돈버는 환상을 깨고, 나에게 맞는 더 현명한 선택을 할 수 있을테니까.]]></summary></entry><entry><title type="html">Isomorphism between Montgomery Curves</title><link href="https://gusgkr0117.github.io/2024/02/25/Isomorphism-between-Montgomery-Curves.html" rel="alternate" type="text/html" title="Isomorphism between Montgomery Curves" /><published>2024-02-25T00:00:00+09:00</published><updated>2024-02-25T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2024/02/25/Isomorphism-between-Montgomery-Curves</id><content type="html" xml:base="https://gusgkr0117.github.io/2024/02/25/Isomorphism-between-Montgomery-Curves.html"><![CDATA[<ul>
  <li>Computing the isomorphism between given two Montgomery curves</li>
  <li>Usefulness of 2-torsion points on Montgomery curves</li>
</ul>

<p>Implementing <a href="https://eprint.iacr.org/2023/660">FESTA</a>(Isogeny based PKE), I needed to implement the point evaluation through an isomorphism between given two curves. I looked it up and couldn’t find any paper explaining about this. Possibly i’m the only one who couldn’t find it. Anyway I decided to derive a proper algorithm for this myself. In this article, I will explain how I did to compute the isomorphism in an efficient way when two distinct Montgomery curves are given as input.</p>

<h2 id="isomorphism-between-two-montgomery-curves">Isomorphism between two Montgomery curves</h2>
<p>To check if two curves are isomorphic, we need to compare its j-invariant. <a href="https://en.wikipedia.org/wiki/J-invariant">J-invariant</a> is literally a value which is invariant up to isomorphisms. Suppose that we have as input a Montgomery curve below.</p>

<center>
$\begin{aligned}
E_A : y^2 = x^3 + Ax^2 + x \\
\text{ where } A \in \mathbb{F}_{p^2}
\end{aligned}
$</center>

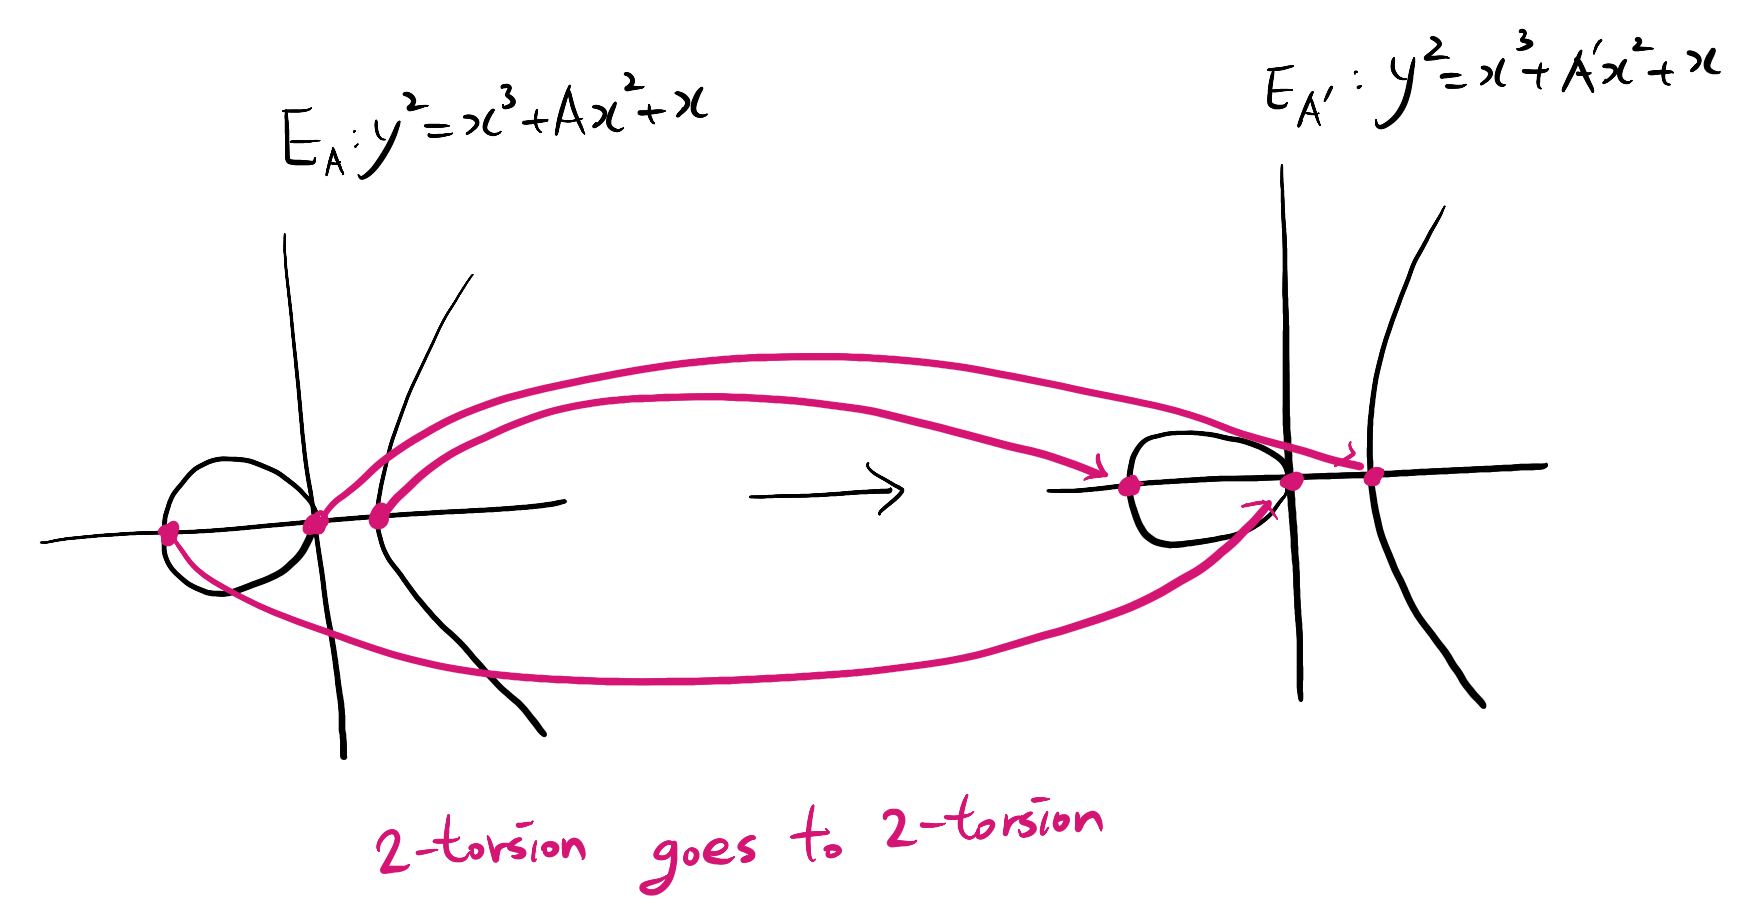
<p>The j-invariant of this curve is known as $j(E) = 8(A^2 - 3)^3/(A^2 - 4) \in \mathbb{F}_{p^2}$. If we are given another Montgomery curve $E_{A’}$, the condition for the equivalence of these curves is $(A’^2 - 3)^3/(A’^2-4) = (A^2 -3)^3/(A^2 -4)$. Through this equation, we can easily expect that $E_{-A}$ is always isomorphic with $E_{A}$. This form of equivalent curve is called <a href="https://en.wikipedia.org/wiki/Twists_of_elliptic_curves"><em>twisted curve</em></a> and we already know that the isomorphism is $(x,y) \mapsto (-x,yi) $. However, there are still other equivalent curves than the twisted curve and we need to find the isomorphisms to them. How can we efficiently find the isomorphism between two given equivalent curves?</p>

<h2 id="looking-at-the-2-torsion-points">Looking at the 2-torsion points</h2>
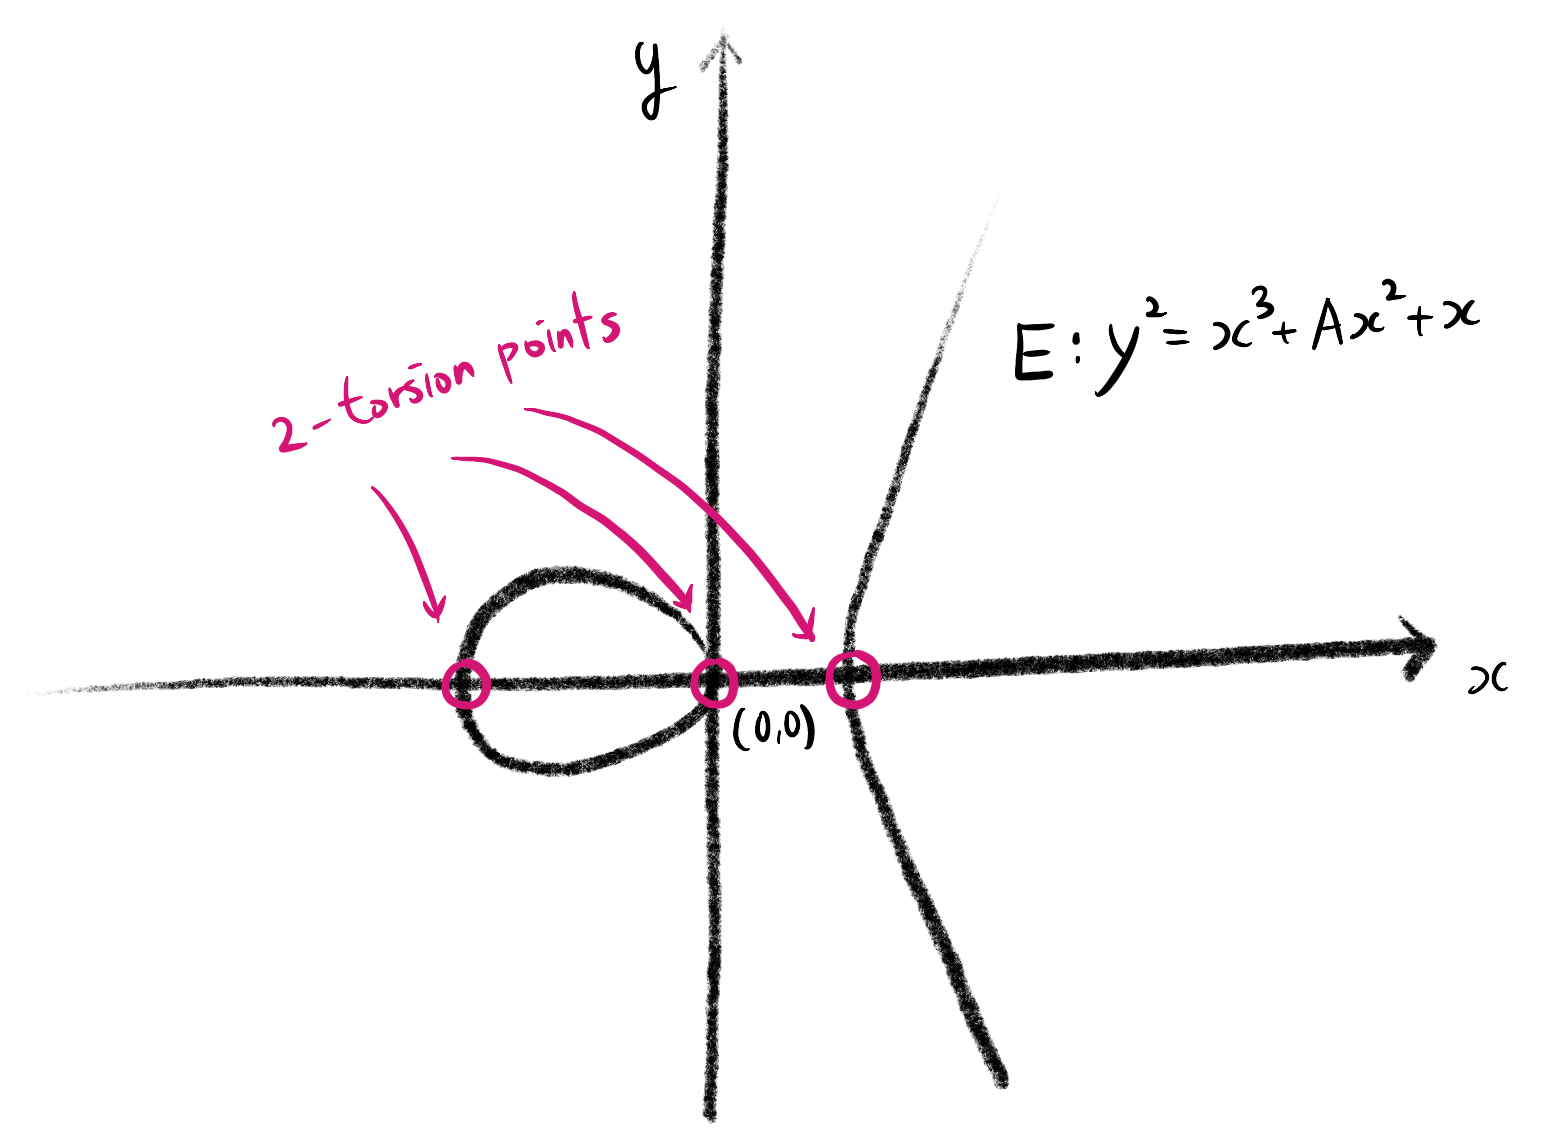
<p>A Montgomery curve always has all three 2-torsion points on the horizontal line $y=0$. One of them is obviously $(0,0)$ which satisfies the curve equation and the other two points satisfy the equation $x^2 + Ax + 1 = 0$(For non-singular cases, we don’t need to consider the multiple root). If there is an isomorphism between $E_A$ and $E_{A’}$, the 2-torsion points on $E_A$ are mapped to the 2-torsion points on $E_{A’}$, which is pretty obvious. Since the isomorphism is consisted of scalings and transitions, we can try all scaling and transition functions which maps 2-torsion points to 2-torsion points, which simplifies our problem.</p>

<center>
<figure>
<img src="/assets/20240225/montgomery_curve.png" width="70%" />
<img src="/assets/20240225/2-torsion.png" width="70%" />
</figure>
</center>

<h2 id="finding-the-isomorphism">Finding the isomorphism</h2>
<p>We can represent an isomorphism $\phi : E_A \rightarrow E_{A’}$ as a map $(x,y) \mapsto (ux+v, wy)$ where $u, v \neq 0$. By applying this map to the curve equation of $E_A$, we obtain the four equations below and $u, v$ can be represented by $A$ and $A’$. Excluding the twisted curve case, we can get $v \neq 0$.</p>

<center>
$
\begin{aligned}
E_{A'}(ux+v, wy) : w^2y^2 &amp;= (ux+v)^3 + A'(ux+v)^2 + (ux+v) \cong E_{A} \\
\Leftrightarrow v^2 + A'v + 1 &amp;= 0\\
u^3 &amp;= w^2 \\
3v + A' &amp;= uA \\
v^2 - 1 &amp;= u^2
\end{aligned}
$
</center>

<p>These four equations are reduced to $v = \frac{A’^2 + 2A^2 - 9}{A’(3 - A^2)}$ and $u = \frac{3v + A’}{A}$. Note that we cannot determine $w$ uniquely but this isn’t any matter for us to compute corresponding kernel group instead of the specific point. In practice we only use points on the <em>Kummer line</em> instead of the points on the real curve even when we calculate an isogeny.</p>

<h2 id="implementation">Implementation</h2>
<p>Using <a href="https://www.rust-lang.org/">Rust</a>, you can implement above equation as follows :</p>
<div class="language-rust highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">#[derive(Clone)]</span>
<span class="k">pub</span> <span class="k">struct</span> <span class="n">CurveIsomorphism</span> <span class="p">{</span>
    <span class="n">u</span><span class="p">:</span> <span class="n">Fq</span><span class="p">,</span>
    <span class="n">v</span><span class="p">:</span> <span class="n">Fq</span><span class="p">,</span>
    <span class="n">w</span><span class="p">:</span> <span class="n">Fq</span><span class="p">,</span>
<span class="p">}</span>

<span class="k">impl</span> <span class="n">CurveIsomorphism</span> <span class="p">{</span>
    <span class="k">pub</span> <span class="k">fn</span> <span class="nf">new</span><span class="p">(</span><span class="n">domain</span><span class="p">:</span> <span class="o">&amp;</span><span class="n">Curve</span><span class="p">,</span> <span class="n">codomain</span><span class="p">:</span> <span class="o">&amp;</span><span class="n">Curve</span><span class="p">)</span> <span class="k">-&gt;</span> <span class="k">Self</span> <span class="p">{</span>
        <span class="nd">debug_assert_eq!</span><span class="p">(</span>
            <span class="n">domain</span><span class="nf">.j_invariant</span><span class="p">(),</span>
            <span class="n">codomain</span><span class="nf">.j_invariant</span><span class="p">(),</span>
            <span class="s">"Given curves are not isomorphic!"</span>
        <span class="p">);</span>
        <span class="k">let</span> <span class="p">(</span><span class="n">A2</span><span class="p">,</span> <span class="n">A1</span><span class="p">)</span> <span class="o">=</span> <span class="p">(</span><span class="n">domain</span><span class="nf">.get_constant</span><span class="p">(),</span> <span class="n">codomain</span><span class="nf">.get_constant</span><span class="p">());</span>
        <span class="k">let</span> <span class="n">v</span> <span class="o">=</span> <span class="p">(</span><span class="n">A1</span><span class="nf">.square</span><span class="p">()</span> <span class="o">+</span> <span class="n">A2</span><span class="nf">.square</span><span class="p">()</span><span class="nf">.mul2</span><span class="p">()</span> <span class="o">-</span> <span class="nn">Fq</span><span class="p">::</span><span class="n">THREE</span><span class="nf">.square</span><span class="p">())</span>
            <span class="o">/</span> <span class="p">(</span><span class="n">A1</span> <span class="o">*</span> <span class="p">(</span><span class="nn">Fq</span><span class="p">::</span><span class="n">THREE</span> <span class="o">-</span> <span class="n">A2</span><span class="nf">.square</span><span class="p">()));</span>
        <span class="k">let</span> <span class="n">u</span> <span class="o">=</span> <span class="p">(</span><span class="nn">Fq</span><span class="p">::</span><span class="n">THREE</span> <span class="o">*</span> <span class="n">v</span> <span class="o">+</span> <span class="n">A1</span><span class="p">)</span> <span class="o">/</span> <span class="n">A2</span><span class="p">;</span>
        <span class="k">let</span> <span class="n">w</span> <span class="o">=</span> <span class="p">(</span><span class="n">u</span> <span class="o">*</span> <span class="n">u</span><span class="nf">.square</span><span class="p">())</span><span class="nf">.sqrt</span><span class="p">()</span><span class="na">.0</span><span class="p">;</span>
        <span class="n">CurveIsomorphism</span> <span class="p">{</span> <span class="n">u</span><span class="p">,</span> <span class="n">v</span><span class="p">,</span> <span class="n">w</span> <span class="p">}</span>
    <span class="p">}</span>

    <span class="k">pub</span> <span class="k">fn</span> <span class="nf">eval</span><span class="p">(</span><span class="o">&amp;</span><span class="k">self</span><span class="p">,</span> <span class="n">P</span><span class="p">:</span> <span class="o">&amp;</span><span class="n">Point</span><span class="p">)</span> <span class="k">-&gt;</span> <span class="n">Point</span> <span class="p">{</span>
        <span class="k">let</span> <span class="p">(</span><span class="n">Px</span><span class="p">,</span> <span class="n">Py</span><span class="p">)</span> <span class="o">=</span> <span class="n">P</span><span class="nf">.to_xy</span><span class="p">();</span>
        <span class="k">let</span> <span class="n">imP</span> <span class="o">=</span> <span class="nn">Point</span><span class="p">::</span><span class="nf">new_xy</span><span class="p">(</span><span class="o">&amp;</span><span class="p">(</span><span class="k">self</span><span class="py">.u</span> <span class="o">*</span> <span class="n">Px</span> <span class="o">+</span> <span class="k">self</span><span class="py">.v</span><span class="p">),</span> <span class="o">&amp;</span><span class="p">(</span><span class="k">self</span><span class="py">.w</span> <span class="o">*</span> <span class="n">Py</span><span class="p">));</span>
        <span class="n">imP</span>
    <span class="p">}</span>
<span class="p">}</span>
</code></pre></div></div>
<p>The entire source code is available at my <a href="https://github.com/gusgkr0117/festa_rs">festa_rs github</a></p>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Mathematics" /><category term="PQCrypto" /><summary type="html"><![CDATA[Computing the isomorphism between given two Montgomery curves Usefulness of 2-torsion points on Montgomery curves Implementing FESTA(Isogeny based PKE), I needed to implement the point evaluation through an isomorphism between given two curves. I looked it up and couldn’t find any paper explaining about this. Possibly i’m the only one who couldn’t find it. Anyway I decided to derive a proper algorithm for this myself. In this article, I will explain how I did to compute the isomorphism in an efficient way when two distinct Montgomery curves are given as input. Isomorphism between two Montgomery curves To check if two curves are isomorphic, we need to compare its j-invariant. J-invariant is literally a value which is invariant up to isomorphisms. Suppose that we have as input a Montgomery curve below. $\begin{aligned} E_A : y^2 = x^3 + Ax^2 + x \\ \text{ where } A \in \mathbb{F}_{p^2} \end{aligned} $ The j-invariant of this curve is known as $j(E) = 8(A^2 - 3)^3/(A^2 - 4) \in \mathbb{F}_{p^2}$. If we are given another Montgomery curve $E_{A’}$, the condition for the equivalence of these curves is $(A’^2 - 3)^3/(A’^2-4) = (A^2 -3)^3/(A^2 -4)$. Through this equation, we can easily expect that $E_{-A}$ is always isomorphic with $E_{A}$. This form of equivalent curve is called twisted curve and we already know that the isomorphism is $(x,y) \mapsto (-x,yi) $. However, there are still other equivalent curves than the twisted curve and we need to find the isomorphisms to them. How can we efficiently find the isomorphism between two given equivalent curves? Looking at the 2-torsion points A Montgomery curve always has all three 2-torsion points on the horizontal line $y=0$. One of them is obviously $(0,0)$ which satisfies the curve equation and the other two points satisfy the equation $x^2 + Ax + 1 = 0$(For non-singular cases, we don’t need to consider the multiple root). If there is an isomorphism between $E_A$ and $E_{A’}$, the 2-torsion points on $E_A$ are mapped to the 2-torsion points on $E_{A’}$, which is pretty obvious. Since the isomorphism is consisted of scalings and transitions, we can try all scaling and transition functions which maps 2-torsion points to 2-torsion points, which simplifies our problem. Finding the isomorphism We can represent an isomorphism $\phi : E_A \rightarrow E_{A’}$ as a map $(x,y) \mapsto (ux+v, wy)$ where $u, v \neq 0$. By applying this map to the curve equation of $E_A$, we obtain the four equations below and $u, v$ can be represented by $A$ and $A’$. Excluding the twisted curve case, we can get $v \neq 0$. $ \begin{aligned} E_{A'}(ux+v, wy) : w^2y^2 &amp;= (ux+v)^3 + A'(ux+v)^2 + (ux+v) \cong E_{A} \\ \Leftrightarrow v^2 + A'v + 1 &amp;= 0\\ u^3 &amp;= w^2 \\ 3v + A' &amp;= uA \\ v^2 - 1 &amp;= u^2 \end{aligned} $ These four equations are reduced to $v = \frac{A’^2 + 2A^2 - 9}{A’(3 - A^2)}$ and $u = \frac{3v + A’}{A}$. Note that we cannot determine $w$ uniquely but this isn’t any matter for us to compute corresponding kernel group instead of the specific point. In practice we only use points on the Kummer line instead of the points on the real curve even when we calculate an isogeny. Implementation Using Rust, you can implement above equation as follows : #[derive(Clone)] pub struct CurveIsomorphism { u: Fq, v: Fq, w: Fq, } impl CurveIsomorphism { pub fn new(domain: &amp;Curve, codomain: &amp;Curve) -&gt; Self { debug_assert_eq!( domain.j_invariant(), codomain.j_invariant(), "Given curves are not isomorphic!" ); let (A2, A1) = (domain.get_constant(), codomain.get_constant()); let v = (A1.square() + A2.square().mul2() - Fq::THREE.square()) / (A1 * (Fq::THREE - A2.square())); let u = (Fq::THREE * v + A1) / A2; let w = (u * u.square()).sqrt().0; CurveIsomorphism { u, v, w } } pub fn eval(&amp;self, P: &amp;Point) -&gt; Point { let (Px, Py) = P.to_xy(); let imP = Point::new_xy(&amp;(self.u * Px + self.v), &amp;(self.w * Py)); imP } } The entire source code is available at my festa_rs github]]></summary></entry><entry><title type="html">Math and Philosophy 1</title><link href="https://gusgkr0117.github.io/2023/12/25/Math-and-Philosophy.html" rel="alternate" type="text/html" title="Math and Philosophy 1" /><published>2023-12-25T00:00:00+09:00</published><updated>2023-12-25T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2023/12/25/Math-and-Philosophy</id><content type="html" xml:base="https://gusgkr0117.github.io/2023/12/25/Math-and-Philosophy.html"><![CDATA[<ul>
  <li>수학이 제시하는 철학적 질문에 대한 고찰의 시작</li>
  <li>수학은 추상화를 통한 생각의 본질에 도달하는 과정</li>
  <li>“나”는 “타인”을 통해 존재한다</li>
</ul>

<p>얼마전 differential manifold에 관해 공부하다가 문득 철학적인 의문이 떠올랐다. 과연 우리가 생각하는 공간이란 무엇일까?
또한 어떤 사물(Object)이 존재한다는 것은 무엇인가? 이 질문에 답하기에 앞서, 내가 왜 이런 질문을 갖게 되었는지 설명해보려한다.</p>

<h2 id="사과는-무엇인가">사과는 무엇인가?</h2>

<p>우리가 살면서 보고, 듣고, 만져서 지각하는 사물은 무수히 많다. 그리고 우리는 사물들을 주로 “언어”를 통해 인지하고, 분류한다. 예를들어 “사과”를 떠올려보자.
내 앞에 두 개의 사과가 있는데 하나는 멀쩡하고, 하나는 벌레가 파먹었다고 해보자. 그럼 이 둘은 분명 다른데 왜 같은 “사과”라고 생각하는걸까?
보기에 달라보이는 둘의 공통점은 같은 “성질”을 지니고 있다는 것이다. 이 “사과의 성질”을 색이 빨갛고, 베어먹으면 아삭한 식감을 가지고 단단한 것이라고 정의해보자.
하지만 이 “성질”은 아직 “사과”들만 지칭하기엔 아직 부족하다. 사과도 덜 익었을 때 색이 달라지고, 아삭하고, 단단한 과일들은 사과 말고도 많기 때문이다.
사실 우리는 이것이 분류학이 탄생한 이유임을 알고 있다. 많은 전문가들이 이미 “사과”의 생물학적 분류를 만들어 놓았다. 조금만 찾아보면 사과는 식물 중에서 속씨식물군으로 분류되며, 장미목, 장미과 등등에 속한다고 한다.
나는 여기서 조금 더 이상한 질문을 해보려 한다. 이런 분류를 하기 위해서는 사과의 식물세포 안에 들어있는 DNA가 같은지 다른지를 판단하는 과정이 수반된다.
그렇다면 어떤 두 DNA가 “같다”라는 것은 무엇인가? 어떤 두 object가 같은가 다른가를 판단하는 것을 조금 깊게 생각해보면, 우린 사실 아무것도 모르고 있다는 결론에 이르게된다.</p>

<h2 id="같음은-무엇인가">같음은 무엇인가?</h2>

<p>두 과일의 차이점을 분석하기 위해 DNA 분석을 진행한다고 해보자. DNA가 같다는 것은 무엇인가? 당연히 DNA를 구성하는 분자구조가 같음을 의미한다.
분자구조가 같다는 것은 무엇인가? 분자를 구성하는 원자들의 종류와 원자들이 결합해있는 모양이 같다라는 것이다.
모양이 같다는 것은 그럼 무엇인가? 언뜻 당연해 보이는 질문이지만, 조금 생각해보면 우리는 사실 이 질문에 답하지 못한다. 정말 간단하고 쉬운 질문 같아 보이지만, 우리는 “같음”에 대한 정의를 가지고 있지 않다.
혹자는 “아니 우리는 오감을 통해 본능적으로 같은 사물들을 분류하고, 인지하는 것인데, 굳이 복잡한 정의를 만들어서 그것에 부합하는지 일일이 확인할 필요가 있나?”라고 질문할 것이다.
그러면 나는 되묻는다. “나와 타인의 오감이 같은 것을 인지하고 있음을 어떻게 아는가? 그리고 인지하는 것이 ‘같음’은 어떻게 알 수 있는가?”
현실에서 두 개의 object가 “같다”라고 하는 것은 실제로 완벽하게 엄밀하지 않다. 같은지 다른지 판단조차 할 수 없는게 현실이다.
이런 복잡하고 알 수 없는 현실세계를 잠시 떠나서 공리를 통해 구축된 완벽한 사고실험을 할 수 있는 고요한 수학의 세계로 가보자.</p>

<h2 id="공간의-같음은-무엇인가">공간의 같음은 무엇인가?</h2>

<p>수학의 세계에서도 사실 “같음”을 우리는 잘 모른다. 물론, 1과 1이 서로 같음을 알 수 있다. 평면에서 한 점으로부터 같은 거리에 있는 점들의 집합을 원이라고 하면, 반지름이 같은 원과 원은 같다.
하지만 그런 것은 사실 “분류”라고 할 수 없다. “1과 1이 같다”라고 말할 때 “같음”은 사실 동어반복이다. “1월은 1월이야” 또는 “사과는 사과야”라고 말하는 것에 지나지 않는다. 의미가 없다는 뜻이다.
의미있는 분류를 시작하기위해, 먼저 우리의 직관적인 판단(또는 본능)에 의존해보자. 우리는 반지름의 크기가 다른 원도 같은 “원”으로 부른다. 모든 약간 찌그러진 원은 “타원”이라고 부른다.
모든 평평한 면을 “평면”이라고 부르고, 높이와 반지름에 상관없이 원통으로 생긴 것들을 모두 “원기둥”으로 부른다. 생각해보면 이는 현실세계에서 우리가 물체를 인식하는 방법(보고, 만지고, 듣고)으로부터 나온 분류법이지만,
여기에 어떤 “규칙”을 우리는 찾을 수 있다. 반지름의 크기와 상관없이, 찌그러진 정도와 상관없이, 높이와 밑면에 상관없이 라는 말들을 곰곰히 생각해보면 이를 다시말해
“자르지 않고, 늘이거나 줄이거나 구부려도 우리는 같은 것으로 본다”라는 기준을 세워볼 수 있다.
이 기준이 절대적으로 옳다라는 것은 아니다.(옳은 것은 사실 없다. 이 기준을 통해 분류하면 원과 타원은 같게 된다.) 다만 일단 이렇게 기준을 세워놓고 이 기준에 맞게 수학적 정의들을 세운 뒤, 물체를 분류했을 때, 우리의 직관과 얼마나 잘
맞아 떨어지는지 보는 것은 매우 흥미로울 것이다. 이것이 가능하다면 이는 위상수학(Topology)으로 이어지는데 위상에 대한 기술적 분석은 다음에 다루려고 한다. 그전에 우리는 도대체 뭘 늘이고 줄인다는 것인지 알아야한다.</p>

<h2 id="뭘-늘이고-줄이고-구부린다는-것인가">뭘 늘이고 줄이고 구부린다는 것인가?</h2>

<p>도대체 뭘 늘이고, 줄이고, 구부린다는 것인가? 사고 실험은 말 그대로 눈에 보이지 않고, 만져지지도 않는 것인데 “무엇”을 늘이고, 줄인다는 것일까?
그래서 우리는 “무엇”이 필요하다. 정확히는 “존재”가 필요하다. A가 “존재한다” 또는 “존재하지 않는다”는 것을 말할 수 있어야 우리는 모든 것을 시작할 수 있다.
이것이 바로 집합론(Set theory)의 시작이다. “존재”라는 단어 마저도 “B”라고 추상화하면 앞의 문장은 “A가 B한다.” 또는 “A가 B하지 않는다.” 라고 말할 수 있다. 이 둘은 동시에 만족할 수 없다.
우리는 이것을 Set B라고 한다. A는 Set B에 포함되거나 포함되지 않으며, 둘을 동시에 만족시킬 수 없다. 이러한 논리를 전개할 수 있는 세계를 정의한 것이 수학적 “공리”다.</p>

<blockquote>
  <p><em>수학은 사실 현실세계를 그대로 표상하기 위한 것은 아니다. 현실에서 우리가 보고, 듣고, 맡고, 만져서 알아낸 어떤 패턴으로부터 영감을 받아 우리의 머릿속에서 만들어낸 이상적인 세계다.</em>
<em>우리는 그것으로 그저 놀 뿐이다. 그 안에 어떤 의미가 있을 수도 있고, 없을 수도 있으며, 의미를 찾는 것 자체가 무의미 할 수 있다.</em></p>
</blockquote>

<p>여기서 우리는 굉장히 재미있는 철학적 교훈을 얻을 수 있다. 우리는 분명 A의 존재성을 나타내려고 했는데, B가 필요하게 되었다. “A는 B이다.”라는 어떤 “의미있는” 명제를 만들어내기 위해서는
두 개의 object가 필요하다는 것을 깨닫는다. A의 존재는 B로부터 출발하고, B의 존재도 A로부터 출발한다. 이 둘은 서로를 존재하게 하며, 서로 다르지만 사실 다르지 않다.(언뜻 불교에서 말하는 깨달음일지도 모르겠다.)
여기서 말하는 것은 단순한 말장난이 아니다. 더 나아가면 어떤 object의 본질은 사실 다른 object와의 상호작용이라는 것을 알 수 있다. 결국 상호작용, 관계맺음 자체가 우리의 존재다.</p>

<blockquote>
  <p><em>타자와의 상호작용이 없으면 우리는 없어진다.</em></p>
</blockquote>

<p>이렇듯 수학의 세계에서 얻은 영감은 다시 현실세계의 교훈이 된다. “나”라는 의식은 내 환경과의 상호작용 그 자체이며, “사람”으로써 “나라는 사람”은 다른 사람과의 상호작용 그 자체이다.
반대로 주변환경과의 상호작용이 없으면(깜깜한 암흑 속, 텅빈 공간, 죽음 등) 나는 없으며, 다른사람과의 상호작용이 없으면(인간이 멸종한 세계, 외계인의 행성 등) 나는 사람이 아니다.
정말 재밌지 않은가? 다시 사과얘기로 돌아가보자. 사과를 사과라고 말해줄 수 있는 사람이 없으면 그것은 사과라고 할 수 있을까? 사과를 보는 내 머릿속에 그려진 어떤 것과
사과를 보는 다른 사람의 머릿속에 그려진 어떤 것이 서로 관계 맺어지지 않으면 “사과”라는 분류자체가 존재할 수 있을까?</p>

<h2 id="수학적-사고에는-철학이-들어있다">수학적 사고에는 철학이 들어있다</h2>

<p>집합론을 처음 배울 때, Set은 element의 모임인 것을 배운다. Element는 set에 포함되거나 포함되지 않으며, 동시에 만족할 수 없다. 사실 여기까지는 직관적이고, 쉽다. 그러나 조금 지나면
우리는 set간에 function이라는 것을 배우고, topology에서는 continuous function을 정의한다. 수학은 사실 항상 이런식이다. 어떤 object를 만들면, 같은 카테고리에 속하는 다른 object와의
관계(morphism)을 연구한다. 두 Set은 사실 function으로 연결되고, 두 topology space는 continuous function으로 연결되고, 두 group은 homomorphism으로 연결된다.(이런 패턴에 관심이 있다면
Category theorem을 찾아보시길..) 처음 이런 낯선 개념들을 배울 때 왜 수학자는 어떻게든 function을 정의하고 연구하려고 하는걸까 궁금했다. 하지만 이제는 알게되었다. object들은 morphism이며,
그 둘은 같은 것임을. 절대적으로 단독으로 존재하는 것은 없다. 모든 것은 상대적이며 둘 이상의 상호작용으로 존재한다.</p>

<p>이러한 수학적 사고에는 사실 언뜻보면 불교사상과도 같은 철학적 사상이 담겨있다. 수학을 공부할 때 이러한 철학적 사상을 염두해두고 공부하면 수학자들이 어떤 의도를 가지고 논리를 만들었는지
조금 더 수월하게 이해가 간다. 이것을 알고 수학을 공부하는 것과 모르고 수학을 공부하는 것은 천지(天地) 차이다. 혹자는 수학을 단순히 패턴을 찾아내는 것으로 배웠거나 그렇게 생각할 수도 있다.
나도 그렇게 생각했고, 패턴을 찾는 즐거운 놀이(?)로 생각하기도 했었다. 하지만 패턴을 찾는 것은 수학을 하기위한 “도구”일 뿐이다. 수학은 본질을 찾아내는 것이다. 그리고 그것은 철학이다.
의미있는 수학은 사실 철학이다.</p>

<blockquote>
  <p><em>난 왜 철학이 문과인지 모르겠다.</em></p>
</blockquote>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Mathematics" /><summary type="html"><![CDATA[수학이 제시하는 철학적 질문에 대한 고찰의 시작 수학은 추상화를 통한 생각의 본질에 도달하는 과정 “나”는 “타인”을 통해 존재한다 얼마전 differential manifold에 관해 공부하다가 문득 철학적인 의문이 떠올랐다. 과연 우리가 생각하는 공간이란 무엇일까? 또한 어떤 사물(Object)이 존재한다는 것은 무엇인가? 이 질문에 답하기에 앞서, 내가 왜 이런 질문을 갖게 되었는지 설명해보려한다. 사과는 무엇인가? 우리가 살면서 보고, 듣고, 만져서 지각하는 사물은 무수히 많다. 그리고 우리는 사물들을 주로 “언어”를 통해 인지하고, 분류한다. 예를들어 “사과”를 떠올려보자. 내 앞에 두 개의 사과가 있는데 하나는 멀쩡하고, 하나는 벌레가 파먹었다고 해보자. 그럼 이 둘은 분명 다른데 왜 같은 “사과”라고 생각하는걸까? 보기에 달라보이는 둘의 공통점은 같은 “성질”을 지니고 있다는 것이다. 이 “사과의 성질”을 색이 빨갛고, 베어먹으면 아삭한 식감을 가지고 단단한 것이라고 정의해보자. 하지만 이 “성질”은 아직 “사과”들만 지칭하기엔 아직 부족하다. 사과도 덜 익었을 때 색이 달라지고, 아삭하고, 단단한 과일들은 사과 말고도 많기 때문이다. 사실 우리는 이것이 분류학이 탄생한 이유임을 알고 있다. 많은 전문가들이 이미 “사과”의 생물학적 분류를 만들어 놓았다. 조금만 찾아보면 사과는 식물 중에서 속씨식물군으로 분류되며, 장미목, 장미과 등등에 속한다고 한다. 나는 여기서 조금 더 이상한 질문을 해보려 한다. 이런 분류를 하기 위해서는 사과의 식물세포 안에 들어있는 DNA가 같은지 다른지를 판단하는 과정이 수반된다. 그렇다면 어떤 두 DNA가 “같다”라는 것은 무엇인가? 어떤 두 object가 같은가 다른가를 판단하는 것을 조금 깊게 생각해보면, 우린 사실 아무것도 모르고 있다는 결론에 이르게된다. 같음은 무엇인가? 두 과일의 차이점을 분석하기 위해 DNA 분석을 진행한다고 해보자. DNA가 같다는 것은 무엇인가? 당연히 DNA를 구성하는 분자구조가 같음을 의미한다. 분자구조가 같다는 것은 무엇인가? 분자를 구성하는 원자들의 종류와 원자들이 결합해있는 모양이 같다라는 것이다. 모양이 같다는 것은 그럼 무엇인가? 언뜻 당연해 보이는 질문이지만, 조금 생각해보면 우리는 사실 이 질문에 답하지 못한다. 정말 간단하고 쉬운 질문 같아 보이지만, 우리는 “같음”에 대한 정의를 가지고 있지 않다. 혹자는 “아니 우리는 오감을 통해 본능적으로 같은 사물들을 분류하고, 인지하는 것인데, 굳이 복잡한 정의를 만들어서 그것에 부합하는지 일일이 확인할 필요가 있나?”라고 질문할 것이다. 그러면 나는 되묻는다. “나와 타인의 오감이 같은 것을 인지하고 있음을 어떻게 아는가? 그리고 인지하는 것이 ‘같음’은 어떻게 알 수 있는가?” 현실에서 두 개의 object가 “같다”라고 하는 것은 실제로 완벽하게 엄밀하지 않다. 같은지 다른지 판단조차 할 수 없는게 현실이다. 이런 복잡하고 알 수 없는 현실세계를 잠시 떠나서 공리를 통해 구축된 완벽한 사고실험을 할 수 있는 고요한 수학의 세계로 가보자. 공간의 같음은 무엇인가? 수학의 세계에서도 사실 “같음”을 우리는 잘 모른다. 물론, 1과 1이 서로 같음을 알 수 있다. 평면에서 한 점으로부터 같은 거리에 있는 점들의 집합을 원이라고 하면, 반지름이 같은 원과 원은 같다. 하지만 그런 것은 사실 “분류”라고 할 수 없다. “1과 1이 같다”라고 말할 때 “같음”은 사실 동어반복이다. “1월은 1월이야” 또는 “사과는 사과야”라고 말하는 것에 지나지 않는다. 의미가 없다는 뜻이다. 의미있는 분류를 시작하기위해, 먼저 우리의 직관적인 판단(또는 본능)에 의존해보자. 우리는 반지름의 크기가 다른 원도 같은 “원”으로 부른다. 모든 약간 찌그러진 원은 “타원”이라고 부른다. 모든 평평한 면을 “평면”이라고 부르고, 높이와 반지름에 상관없이 원통으로 생긴 것들을 모두 “원기둥”으로 부른다. 생각해보면 이는 현실세계에서 우리가 물체를 인식하는 방법(보고, 만지고, 듣고)으로부터 나온 분류법이지만, 여기에 어떤 “규칙”을 우리는 찾을 수 있다. 반지름의 크기와 상관없이, 찌그러진 정도와 상관없이, 높이와 밑면에 상관없이 라는 말들을 곰곰히 생각해보면 이를 다시말해 “자르지 않고, 늘이거나 줄이거나 구부려도 우리는 같은 것으로 본다”라는 기준을 세워볼 수 있다. 이 기준이 절대적으로 옳다라는 것은 아니다.(옳은 것은 사실 없다. 이 기준을 통해 분류하면 원과 타원은 같게 된다.) 다만 일단 이렇게 기준을 세워놓고 이 기준에 맞게 수학적 정의들을 세운 뒤, 물체를 분류했을 때, 우리의 직관과 얼마나 잘 맞아 떨어지는지 보는 것은 매우 흥미로울 것이다. 이것이 가능하다면 이는 위상수학(Topology)으로 이어지는데 위상에 대한 기술적 분석은 다음에 다루려고 한다. 그전에 우리는 도대체 뭘 늘이고 줄인다는 것인지 알아야한다. 뭘 늘이고 줄이고 구부린다는 것인가? 도대체 뭘 늘이고, 줄이고, 구부린다는 것인가? 사고 실험은 말 그대로 눈에 보이지 않고, 만져지지도 않는 것인데 “무엇”을 늘이고, 줄인다는 것일까? 그래서 우리는 “무엇”이 필요하다. 정확히는 “존재”가 필요하다. A가 “존재한다” 또는 “존재하지 않는다”는 것을 말할 수 있어야 우리는 모든 것을 시작할 수 있다. 이것이 바로 집합론(Set theory)의 시작이다. “존재”라는 단어 마저도 “B”라고 추상화하면 앞의 문장은 “A가 B한다.” 또는 “A가 B하지 않는다.” 라고 말할 수 있다. 이 둘은 동시에 만족할 수 없다. 우리는 이것을 Set B라고 한다. A는 Set B에 포함되거나 포함되지 않으며, 둘을 동시에 만족시킬 수 없다. 이러한 논리를 전개할 수 있는 세계를 정의한 것이 수학적 “공리”다. 수학은 사실 현실세계를 그대로 표상하기 위한 것은 아니다. 현실에서 우리가 보고, 듣고, 맡고, 만져서 알아낸 어떤 패턴으로부터 영감을 받아 우리의 머릿속에서 만들어낸 이상적인 세계다. 우리는 그것으로 그저 놀 뿐이다. 그 안에 어떤 의미가 있을 수도 있고, 없을 수도 있으며, 의미를 찾는 것 자체가 무의미 할 수 있다. 여기서 우리는 굉장히 재미있는 철학적 교훈을 얻을 수 있다. 우리는 분명 A의 존재성을 나타내려고 했는데, B가 필요하게 되었다. “A는 B이다.”라는 어떤 “의미있는” 명제를 만들어내기 위해서는 두 개의 object가 필요하다는 것을 깨닫는다. A의 존재는 B로부터 출발하고, B의 존재도 A로부터 출발한다. 이 둘은 서로를 존재하게 하며, 서로 다르지만 사실 다르지 않다.(언뜻 불교에서 말하는 깨달음일지도 모르겠다.) 여기서 말하는 것은 단순한 말장난이 아니다. 더 나아가면 어떤 object의 본질은 사실 다른 object와의 상호작용이라는 것을 알 수 있다. 결국 상호작용, 관계맺음 자체가 우리의 존재다. 타자와의 상호작용이 없으면 우리는 없어진다. 이렇듯 수학의 세계에서 얻은 영감은 다시 현실세계의 교훈이 된다. “나”라는 의식은 내 환경과의 상호작용 그 자체이며, “사람”으로써 “나라는 사람”은 다른 사람과의 상호작용 그 자체이다. 반대로 주변환경과의 상호작용이 없으면(깜깜한 암흑 속, 텅빈 공간, 죽음 등) 나는 없으며, 다른사람과의 상호작용이 없으면(인간이 멸종한 세계, 외계인의 행성 등) 나는 사람이 아니다. 정말 재밌지 않은가? 다시 사과얘기로 돌아가보자. 사과를 사과라고 말해줄 수 있는 사람이 없으면 그것은 사과라고 할 수 있을까? 사과를 보는 내 머릿속에 그려진 어떤 것과 사과를 보는 다른 사람의 머릿속에 그려진 어떤 것이 서로 관계 맺어지지 않으면 “사과”라는 분류자체가 존재할 수 있을까? 수학적 사고에는 철학이 들어있다 집합론을 처음 배울 때, Set은 element의 모임인 것을 배운다. Element는 set에 포함되거나 포함되지 않으며, 동시에 만족할 수 없다. 사실 여기까지는 직관적이고, 쉽다. 그러나 조금 지나면 우리는 set간에 function이라는 것을 배우고, topology에서는 continuous function을 정의한다. 수학은 사실 항상 이런식이다. 어떤 object를 만들면, 같은 카테고리에 속하는 다른 object와의 관계(morphism)을 연구한다. 두 Set은 사실 function으로 연결되고, 두 topology space는 continuous function으로 연결되고, 두 group은 homomorphism으로 연결된다.(이런 패턴에 관심이 있다면 Category theorem을 찾아보시길..) 처음 이런 낯선 개념들을 배울 때 왜 수학자는 어떻게든 function을 정의하고 연구하려고 하는걸까 궁금했다. 하지만 이제는 알게되었다. object들은 morphism이며, 그 둘은 같은 것임을. 절대적으로 단독으로 존재하는 것은 없다. 모든 것은 상대적이며 둘 이상의 상호작용으로 존재한다. 이러한 수학적 사고에는 사실 언뜻보면 불교사상과도 같은 철학적 사상이 담겨있다. 수학을 공부할 때 이러한 철학적 사상을 염두해두고 공부하면 수학자들이 어떤 의도를 가지고 논리를 만들었는지 조금 더 수월하게 이해가 간다. 이것을 알고 수학을 공부하는 것과 모르고 수학을 공부하는 것은 천지(天地) 차이다. 혹자는 수학을 단순히 패턴을 찾아내는 것으로 배웠거나 그렇게 생각할 수도 있다. 나도 그렇게 생각했고, 패턴을 찾는 즐거운 놀이(?)로 생각하기도 했었다. 하지만 패턴을 찾는 것은 수학을 하기위한 “도구”일 뿐이다. 수학은 본질을 찾아내는 것이다. 그리고 그것은 철학이다. 의미있는 수학은 사실 철학이다. 난 왜 철학이 문과인지 모르겠다.]]></summary></entry><entry><title type="html">Ideal To Isogeny</title><link href="https://gusgkr0117.github.io/2022/06/18/Isogeny-To-Ideal.html" rel="alternate" type="text/html" title="Ideal To Isogeny" /><published>2022-06-18T00:00:00+09:00</published><updated>2022-06-18T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2022/06/18/Isogeny-To-Ideal</id><content type="html" xml:base="https://gusgkr0117.github.io/2022/06/18/Isogeny-To-Ideal.html"><![CDATA[<ul>
  <li>Deuring Correspondence에 의하면 Isogeny와 Ideal은 대응관계에 있다.</li>
  <li>Supersingular elliptic curve $E$에 대해서 maximal order $\mathcal{O}$에 대해 $\mathrm{End}(E) \cong \mathcal{O}$를 만족할 때, $E$를 codomain으로 가지는 isogeny $\phi:E \rightarrow E’$은 left $\mathcal{O}$-ideal $I$에 대응된다.</li>
  <li>Isogeny 기반 서명 기법인 SQISign에서 서명 시 가장 오래걸리는 부분이 바로 $\mathcal{l}^e$-Ideal을 Isogeny로 변환하는 과정이다.</li>
</ul>

<!--more-->

<h2 id="klpt-알고리즘">KLPT 알고리즘</h2>

<p>KLPT 알고리즘은 임의의 ideal $I$가 주어졌을 때, ideal $I$와 equivalent하면서 원하는 norm을 가지는 다른 ideal $J$를 찾는 알고리즘이다. KLPT 알고리즘은 따로 포스팅을 통해 다루기로하고, 여기서는 KLPT 알고리즘이 IdealToIsogeny에서 어떤 역할을 하고, 이를 어떻게 활용하는지에 대해서만 짚고 넘어가도록 하겠다.</p>

<p>기본적인 KLPT 알고리즘은 special $p$-extremal maximal order $\mathcal{O}_0$의 특성을 활용한다. $\mathcal{O}_0$에는 $\mathbb{Z} + i\mathbb{Z} + j\mathbb{Z} + ij\mathbb{Z}$를 suborder로 포함하고 있다는 특징을 가지며, $\mathcal{O}_0$의 basis는 $1, i, \frac{i + j}{2}, \frac{1 + ij}{2}$이고, supersingular elliptic curve $E(\bar{\mathbb{F}_p}) : y^2 = x^3 + x$의 endomorphism ring과 isomorphic 하다는 것이 알려져있다. 이러한 특별한 maximal order $\mathcal{O}_0$를 이용해 원하는 ideal을 계산하는 것이 KLPT 알고리즘의 핵심이다.</p>

<p>$\mathcal{O}_0$의 basis들을 활용해 원하는 norm을 가지는 원소 $\beta \in I \subset \mathcal{O}_0$를 찾게 되는데, 원하는 norm 값이 $N$이라면, $\gcd(N,n(I)) = 1$을 만족해야만 해 $\beta$를 구할 수 있다.</p>

<h2 id="ideal을-isogeny로-변환">Ideal을 Isogeny로 변환</h2>

<p>left $\mathcal{O}_1$-ideal $I$가 어떤 isogeny $\phi:E_1 \rightarrow E_2$에 대응된다는 것은 알겠는데, left ideal $I$가 주어졌을 때, 대응되는 isogeny를 어떻게 practical하게 계산할 수 있을까? 실제 서명기법에서 활용하기 위해서는 어떻게 효율적으로 계산할 수 있을까?</p>

<p>일단 “효율적으로 계산할 수 있는 Isogeny”란 무엇인가 생각해보아야 한다. Isogeny의 kernel point들이 모두 적절히 낮은 차원의 field extension $\mathbb{F}_{p^n}$ 위에서 정의된다면, Velu’s formula를 이용해 효율적으로 계산할 수 있을 것이다. “적절히 낮은 차원”의 기준을 $\mathbb{F}_{p^2}$ 이라고 한다면, 우리는 모든 연산을 $\mathbb{F}_{p^2}$ 위에서 수행하고 싶은 상황이다.</p>

<h3 id="ideal을-분해하자">Ideal을 분해하자</h3>

<blockquote>
  <p>일단 SQISign의 환경과 같이 주어지는 left ideal $I$의 norm은 $\mathcal{l}^e$ 꼴을 가진다고 하자.</p>
</blockquote>

<p>$E(\mathbb{F}_{p^2})$ 의 point 개수는 유한하기 때문에 $\mathbb{F}_{p^2}$ 으로 계산할 수 있는 isogeny의 최대 degree는 $E(\mathbb{F}_{p^2})$ 의 점 개수로 제한된다. 만일 주어진 ideal의 norm이 $E(\mathbb{F}_{p^2})$의 점 개수를 넘는다면, 우리는 해당 ideal에 대응되는 isogeny의 kernel point를 $\mathbb{F}_{p^2}$ 위에서 표현할 수 없다. 이러한 문제를 해결하기 위해서 우리는 ideal $I$를 degree가 낮은 여러 ideal들로 분해하고, 각각을 $\mathbb{F}_{p^2}$위에서 표현할 것이다.</p>

<p>$n(I) = \mathcal{l}^e$이라고 하자. $\mathbb{F}_{p^2}$위에서 표현할 수 있는 최대 degree가 $\mathcal{l}^f$라고 할 때, $e &gt; f$인 경우, ideal $I$를 분해해야 한다. 이는 아래와 같이 수행할 수 있다.</p>

<p>$I = \mathcal{O}&lt;\alpha, l^e&gt;$이라고 할 때, $I_i = \mathcal{O}&lt;\alpha, l^{if}&gt;$ for $i \in [1,\lfloor e/f\rfloor]$라고 하면, $I \subset I_{\lfloor e/f\rfloor} \subset … \subset I_2 \subset I_1$을 만족한다. $I_i$에 대응되는 isogeny를 $\phi_i$라고 하면, 이를 이용해서 $\phi$를 degree가 $\mathcal{l}^f$보다 작은 isogeny들로 분해할 수 있다.</p>

<h3 id="smooth-odd-degree-isogeny의-필요성">Smooth Odd Degree Isogeny의 필요성</h3>

<blockquote>
  <p>여기서 “odd”가 들어가는 이유는 SQISign에서 실제로는 $l=2$로 사용하기 때문이다. 즉, $l$과 coprime인 smooth degree isogeny의 필요성을 의미한다. 여기서부터는 $l=2$로 가정하고 설명하도록 하겠다.</p>
</blockquote>

<p>left $\mathcal{O}$-ideal $I$의 generator가 $\alpha \in I$라고 할 때, $\alpha$가 실제로 codomain curve $E$에서 어떤 endomorphism에 해당되는지 알아야지 대응되는 $\phi_I$의 kernel을 구할 수 있을 것이다. 하지만 $\mathcal{O}$와 $\mathrm{End}(E)$의 일대일 대응관계를 바로 알아내기가 어렵기 때문에 우리는 sepcial maximal order인 $\mathcal{O}_0$를 활용해야 한다.</p>

<p>$\mathcal{O}_0$를 활용하기 위해서 $\mathcal{O}_0$으로 pull back한 후에, 대응되는 isogeny의 kernel을 구하고, 해당 kernel의 basis를 다시 curve $E$로 push forward 해줄것이다. 그렇다면 $E_0$에서 $E$로 가는 isogeny $\phi_J$가 필요할 것이고, push forward와 pull back을 이용하기 위해서는 $\gcd(n(I), n(J))=1$이라는 조건이 필요하다. 우리가 $I$의 degree는 $\mathcal{l}^e$ 꼴이라는 것을 알고 있으므로, $\mathcal{l}=2$일 때, ideal $J$ degree는 odd이기만 하면 된다. 또한 push forward를 위해서는 $\phi_J$에 대한 point evaluation 연산이 필요하기 때문에 odd이면서 smooth degree를 가져야만 효율적인 연산이 가능하다.</p>

<blockquote>
  <p>다시말해 special order $\mathcal{O}_0$를 활용하기 위해서는 coprime이면서 smooth degree를 갖는 isogeny $\phi_J$를 이용해서 $\mathcal{O}_0$에서 계산한 $\mathcal{l}^e$ degree의 isogeny를 “밀어”(push forward)주어야한다. 따라서 odd smooth isogeny와 odd smooth isogeny computation이 필요하다.</p>
</blockquote>

<h3 id="meet-in-the-middle과-l2fdelta-isogeny">Meet-in-the-Middle과 $l^{2f+\Delta}$-isogeny</h3>

<p>large odd degree isogeny를 연산하는 것은 꽤 오래걸리는 작업이기 때문에 odd degree isogeny 연산 횟수를 줄이는 것이 서명 기법을 빠르게하는 핵심 아이디어가 된다. ideal $I$를 많은 개수의 ideal로 분해할수록 odd degree isogeny의 연산 횟수가 늘어날 것이기 때문에 최대한 적게 분해되도록 해야한다. 이를 위해 SQISign 저자는 meet-in-the-middle을 활용하는 아이디어를 제안했다.</p>

<p>원래는 $\mathcal{l}^{2f}$-degree의 ideal을 isogeny로 변환하려면 odd degree isogeny 연산을 두 번 수행해야 할 것이다. 하지만 저자는 여기에 meet-in-the-middle을 활용하면 작은 degree $\mathcal{l}^{\Delta}$를 가지는 ideal에 한해서는 odd degree isogeny 연산을 할 필요없이 전수조사를 통해서 isogeny로 변환할 수 있다는 사실을 적용했다. 즉, odd degree isogeny 연산을 두 번 수행했을 때, $\mathcal{l}^{2f+\Delta}$만큼의 isogeny를 얻게되기 때문에 변환 속도가 더 빨라지게 된다.</p>

<h3 id="sqisign의-ideal_to_isogeny_two_2f_delta-함수-코드리딩">SQISign의 <code class="language-plaintext highlighter-rouge">ideal_to_isogeny_two_2f_delta</code> 함수 코드리딩</h3>

<p>앞서 설명한 $2^{2f+\Delta}$ degree인 ideal $I$를 isogeny로 변환하는 방식이 <a href="https://github.com/SQISign/sqisign">SQISign Git</a>에 오픈소스로 구현이 되어 있다. 해당 섹션에서는 idiso.c에 구현되어있는 <code class="language-plaintext highlighter-rouge">ideal_to_isogeny_two_2f_delta</code> 함수가 어떻게 구현되어 있는지 따라가보고자 한다.</p>

<p>일단 함수의 인자 값은 아래와 같다.</p>
<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kt">void</span> <span class="n">ideal_to_isogeny_two_2f_delta</span><span class="p">(</span><span class="n">two_walk_long</span> <span class="o">*</span><span class="n">phi</span><span class="p">,</span> <span class="n">GEN</span> <span class="o">*</span><span class="n">L</span><span class="p">,</span>
    <span class="n">special_isogeny</span> <span class="o">*</span><span class="n">phi_L</span><span class="p">,</span> <span class="n">GEN</span> <span class="n">I</span><span class="p">,</span> <span class="n">GEN</span> <span class="n">J</span><span class="p">,</span> <span class="n">GEN</span> <span class="n">K</span><span class="p">,</span>
    <span class="n">proj</span> <span class="o">*</span><span class="n">phi_K_basis</span><span class="p">,</span> <span class="n">proj</span> <span class="o">*</span><span class="n">phi_K_target</span><span class="p">,</span> <span class="kt">int</span> <span class="n">delta</span><span class="p">,</span> <span class="n">GEN</span> <span class="n">I_long</span><span class="p">)</span>
</code></pre></div></div>
<p>변환하고자하는 ideal의 domain을 $E_1$, codomain을 $E_2$라고 할 때, 각 인자에 대한 설명은 아래와 같다.</p>
<ul>
  <li>ideal <code class="language-plaintext highlighter-rouge">J</code>는 odd smooth degree이면서 $E_0 \rightarrow E_1$인 left $\mathcal{O}_0$-ideal이다.</li>
  <li>ideal <code class="language-plaintext highlighter-rouge">I</code>는 변환하고자 하는 ideal과 ideal <code class="language-plaintext highlighter-rouge">J</code>를 합성하여 degree가 $n(J)\cdot \mathcal{l}^{2f+\Delta}$이면서 $E_0 \rightarrow E_2$인 left $\mathcal{O}_0$-ideal이다.</li>
  <li>ideal <code class="language-plaintext highlighter-rouge">K</code>는 ideal <code class="language-plaintext highlighter-rouge">J</code>와 equivalent하면서 degree가 $\mathcal{l}^e$꼴인 left $\mathcal{O}_0$-ideal 이다.</li>
  <li><code class="language-plaintext highlighter-rouge">phi_K_basis</code>는 <code class="language-plaintext highlighter-rouge">I</code> $\subset I_1 \cdot$ <code class="language-plaintext highlighter-rouge">K</code>
인 degree $\mathcal{l}^{f}$인 ideal $I_1$에 대응되는 isogeny를 $\phi_1$이라고 할 때, $\phi_1 \circ \phi_K($<code class="language-plaintext highlighter-rouge">torsion_basis</code>$)$를 계산한 값이다.</li>
  <li><code class="language-plaintext highlighter-rouge">phi_K_target</code>은 $\phi_1 \circ \phi_K$의 codomain curve를 의미한다.</li>
  <li><code class="language-plaintext highlighter-rouge">delta</code>는 meet-in-the-middle을 수행하기 위한 degree $\Delta$를 의미한다.</li>
  <li>ideal <code class="language-plaintext highlighter-rouge">I_long</code>은 ideal <code class="language-plaintext highlighter-rouge">I</code>에 포함되면서 degree가 $\mathcal{l}^{rest}$인 앞으로 변환하고자 하는 나머지 ideal을 의미한다.</li>
</ul>

<p>출력 값은 아래와 같다.</p>
<ul>
  <li><code class="language-plaintext highlighter-rouge">phi</code>는 degree가 $\mathcal{l}^{2f+\Delta}$이면서 $E_1 \rightarrow E_2$인 isogeny를 의미한다.</li>
  <li><code class="language-plaintext highlighter-rouge">L</code>은 odd smooth degree이면서 $E_0 \rightarrow E_1$인 ideal을 의미한다.</li>
  <li><code class="language-plaintext highlighter-rouge">phi_L</code>은 <code class="language-plaintext highlighter-rouge">L</code>에 대응되는 isogeny를 의미한다.</li>
  <li><code class="language-plaintext highlighter-rouge">phi_K_basis</code>와 <code class="language-plaintext highlighter-rouge">phi_K_target</code>에는 다음 ideal 변환과정에 사용할 basis와 codomain curve가 들어간다.</li>
</ul>

<p>다음은 함수의 초반부이다.</p>
<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">GEN</span> <span class="n">L_</span><span class="p">;</span>

    <span class="k">if</span> <span class="p">(</span><span class="n">len_step</span> <span class="o">+</span> <span class="n">Z_lval</span><span class="p">(</span><span class="n">lideal_norm</span><span class="p">(</span><span class="n">K</span><span class="p">),</span> <span class="mi">2</span><span class="p">)</span> <span class="o">&lt;</span> <span class="n">dbllog2r</span><span class="p">(</span><span class="n">itor</span><span class="p">(</span><span class="n">global_setup</span><span class="p">.</span><span class="n">p</span><span class="p">,</span><span class="mi">10</span><span class="p">))</span><span class="o">/</span><span class="mf">2.</span> <span class="o">+</span> <span class="mi">10</span> <span class="p">)</span> <span class="p">{</span>
        <span class="n">GEN</span> <span class="n">M</span><span class="p">;</span>
        <span class="n">GEN</span> <span class="n">alpha</span> <span class="o">=</span> <span class="n">lideal_isom</span><span class="p">(</span><span class="n">J</span><span class="p">,</span> <span class="n">K</span><span class="p">);</span> <span class="c1">// J*alpha = K</span>

        <span class="n">M</span> <span class="o">=</span> <span class="n">lideal_mul</span><span class="p">(</span><span class="n">I</span><span class="p">,</span> <span class="n">alpha</span><span class="p">);</span> <span class="c1">// I*alpha, equivalent to I, but norm a power of 2</span>

        <span class="n">L_</span> <span class="o">=</span> <span class="n">klpt_special_smooth_small_2e_input</span><span class="p">(</span><span class="n">M</span><span class="p">,</span> <span class="n">famat_sqr</span><span class="p">(</span><span class="n">famat_mul</span><span class="p">(</span><span class="n">global_setup</span><span class="p">.</span><span class="n">gen_p_plus_fact</span><span class="p">,</span> <span class="n">global_setup</span><span class="p">.</span><span class="n">gen_p_minus_fact</span><span class="p">)));</span>
    <span class="p">}</span>
    <span class="k">else</span> <span class="p">{</span>
        <span class="n">L_</span> <span class="o">=</span> <span class="n">klpt_special_smooth</span><span class="p">(</span><span class="n">I</span><span class="p">,</span> <span class="n">famat_sqr</span><span class="p">(</span><span class="n">famat_mul</span><span class="p">(</span><span class="n">global_setup</span><span class="p">.</span><span class="n">gen_p_plus_fact</span><span class="p">,</span> <span class="n">global_setup</span><span class="p">.</span><span class="n">gen_p_minus_fact</span><span class="p">)));</span>
    <span class="p">}</span>
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">alpha</code>는 $J\cdot \alpha = K$를 만족하는 $\alpha \in J$를 구한 값으로, $I\cdot \alpha$는 <code class="language-plaintext highlighter-rouge">I</code>에서 <code class="language-plaintext highlighter-rouge">J</code>에 해당하는 부분만 <code class="language-plaintext highlighter-rouge">K</code>로 변환하는 것을 의미한다. 이렇게 나온 ideal <code class="language-plaintext highlighter-rouge">M</code>은 $2^e$ 꼴의 degree를 갖는다. ideal <code class="language-plaintext highlighter-rouge">M</code>을 계산하는 이유는 odd smooth degree이면서 <code class="language-plaintext highlighter-rouge">I</code>와 equivalent한 ideal <code class="language-plaintext highlighter-rouge">L_</code>을 만들기 위해서이다. 이를 위해서는 KLPT 알고리즘을 사용해야하는데 앞서 설명했듯이 이를 위해서는 입력 값으로 들어가는 ideal의 degree가 원하는 odd smooth degree와 서로소여야 한다. 이를 위해서 $2^e$ 꼴의 degree를 갖는 ideal <code class="language-plaintext highlighter-rouge">M</code>을 계산할 필요가 있었던 것이다.</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">GEN</span> <span class="n">a</span> <span class="o">=</span> <span class="n">lideal_isom</span><span class="p">(</span><span class="n">J</span><span class="p">,</span> <span class="n">K</span><span class="p">);</span> <span class="c1">// J*a = K</span>
    <span class="k">if</span> <span class="p">(</span><span class="n">gcmp</span><span class="p">(</span><span class="n">lideal_norm</span><span class="p">(</span><span class="n">K</span><span class="p">),</span> <span class="n">gen_1</span><span class="p">)</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span> <span class="p">{</span> <span class="n">a</span> <span class="o">=</span> <span class="n">alg_scalar</span><span class="p">(</span><span class="n">A</span><span class="p">,</span><span class="n">gen_1</span><span class="p">);</span> <span class="cm">/* make sure we don't apply a distorsion */</span> <span class="p">}</span>

    <span class="n">GEN</span> <span class="n">M</span> <span class="o">=</span> <span class="n">lideal_mul</span><span class="p">(</span><span class="n">I</span><span class="p">,</span> <span class="n">a</span><span class="p">);</span>
    <span class="n">assert</span><span class="p">(</span><span class="n">lideal_isom</span><span class="p">(</span><span class="n">L_</span><span class="p">,</span><span class="n">M</span><span class="p">));</span>
    <span class="n">GEN</span> <span class="n">b</span> <span class="o">=</span> <span class="n">lideal_isom</span><span class="p">(</span><span class="n">L_</span><span class="p">,</span><span class="n">M</span><span class="p">);</span> <span class="c1">// L_*gamma = M</span>
    <span class="n">GEN</span> <span class="n">gamma</span> <span class="o">=</span> <span class="n">gmul</span><span class="p">(</span><span class="n">b</span><span class="p">,</span> <span class="n">lideal_norm</span><span class="p">(</span><span class="n">L_</span><span class="p">));</span>

    <span class="n">GEN</span> <span class="n">n</span><span class="p">;</span>
    <span class="n">alg_primitive</span><span class="p">(</span><span class="o">&amp;</span><span class="n">n</span><span class="p">,</span> <span class="n">A</span><span class="p">,</span> <span class="n">order</span><span class="p">,</span> <span class="n">gamma</span><span class="p">);</span>
    <span class="n">assert</span><span class="p">(</span><span class="n">gcmp</span><span class="p">(</span><span class="n">n</span><span class="p">,</span><span class="n">gen_1</span><span class="p">)</span> <span class="o">==</span> <span class="mi">0</span><span class="p">);</span>


    <span class="n">GEN</span> <span class="n">H1_odd</span> <span class="o">=</span> <span class="n">lideal_create</span><span class="p">(</span><span class="n">A</span><span class="p">,</span> <span class="n">order</span><span class="p">,</span> <span class="n">gamma</span><span class="p">,</span> <span class="n">ggcd</span><span class="p">(</span><span class="n">global_setup</span><span class="p">.</span><span class="n">gen_odd_torsion</span><span class="p">,</span> <span class="n">lideal_norm</span><span class="p">(</span><span class="n">L_</span><span class="p">)));</span>
</code></pre></div></div>

<p>다음은 <code class="language-plaintext highlighter-rouge">gamma</code> 값을 계산해 이를 generator로 하는 degree <code class="language-plaintext highlighter-rouge">T</code>의 left $\mathcal{O}_0$-ideal <code class="language-plaintext highlighter-rouge">H1_odd</code>를 만드는 과정이다. 이렇게 만든 ideal <code class="language-plaintext highlighter-rouge">H1_odd</code>를 통해 대응되는 isogeny kernel을 미리 계산해둔 <code class="language-plaintext highlighter-rouge">T</code>-torsion basis에 대한 계수로 표현하고, <code class="language-plaintext highlighter-rouge">phi_K_basis</code>에 바로 곱해서 더해주면, isogeny 연산 필요없이 바로 push forward된 isogeny $H_1$의 kernel을 얻을 수 있다. 해당 isogeny가 코드에서 <code class="language-plaintext highlighter-rouge">psi_1</code>이고, 이의 dual isogeny가 <code class="language-plaintext highlighter-rouge">psi_1_dual</code>이다.</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">GEN</span> <span class="n">gamma_conj</span> <span class="o">=</span> <span class="n">alg_conj</span><span class="p">(</span><span class="n">A</span><span class="p">,</span> <span class="n">gamma</span><span class="p">);</span>
    <span class="n">GEN</span> <span class="n">H2_odd</span> <span class="o">=</span> <span class="n">lideal_create</span><span class="p">(</span><span class="n">A</span><span class="p">,</span> <span class="n">order</span><span class="p">,</span> <span class="n">gamma_conj</span><span class="p">,</span> <span class="n">gdiv</span><span class="p">(</span><span class="n">lideal_norm</span><span class="p">(</span><span class="n">L_</span><span class="p">),</span> <span class="n">lideal_norm</span><span class="p">(</span><span class="n">H1_odd</span><span class="p">)));</span>
    <span class="n">GEN</span> <span class="n">H2_two</span> <span class="o">=</span> <span class="n">lideal_create</span><span class="p">(</span><span class="n">A</span><span class="p">,</span> <span class="n">order</span><span class="p">,</span> <span class="n">gamma_conj</span><span class="p">,</span> <span class="n">powuu</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span> <span class="n">e2</span><span class="p">));</span>

    <span class="n">odd_isogeny</span> <span class="n">psi_2</span> <span class="o">=</span> <span class="n">ideal_to_isogeny_O0_T</span><span class="p">(</span><span class="n">H2_odd</span><span class="p">,</span> <span class="n">famat_Z_gcd</span><span class="p">(</span><span class="n">famat_mul</span><span class="p">(</span><span class="n">global_setup</span><span class="p">.</span><span class="n">gen_p_plus_fact</span><span class="p">,</span> <span class="n">global_setup</span><span class="p">.</span><span class="n">gen_p_minus_fact</span><span class="p">),</span><span class="n">lideal_norm</span><span class="p">(</span><span class="n">H2_odd</span><span class="p">)));</span>

<span class="p">...</span>

    <span class="n">two_walk</span> <span class="n">phi_2</span> <span class="o">=</span> <span class="n">ideal_to_isogeny_O0_two</span><span class="p">(</span><span class="n">H2_two</span><span class="p">);</span>
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">psi_1</code>을 계산한 이후엔 $\bar{\gamma}$에 해당하는 <code class="language-plaintext highlighter-rouge">gamma_conj</code> 값을 이용해 ideal <code class="language-plaintext highlighter-rouge">H2_odd</code>와 <code class="language-plaintext highlighter-rouge">H2_two</code>를 만든다. 각각은 $n(L)/T$와 $2^{f_2}$ degree를 가진다. <code class="language-plaintext highlighter-rouge">H2_odd</code>는 <code class="language-plaintext highlighter-rouge">ideal_to_isogeny_O0_T</code>라는 함수를 통해 미리 계산된 endomorphism action들을 이용해 isogeny <code class="language-plaintext highlighter-rouge">psi_2</code>로 변환할 수 있으며, <code class="language-plaintext highlighter-rouge">H2_two</code>는 <code class="language-plaintext highlighter-rouge">ideal_to_isogeny_O0_two</code> 함수를 이용해 마찬가지로 isogeny <code class="language-plaintext highlighter-rouge">phi_2</code>로 변환 후, <code class="language-plaintext highlighter-rouge">psi_2</code>를 이용해 push forward한다. 이 때 <code class="language-plaintext highlighter-rouge">psi_2</code>만큼의 odd degree isogeny 연산이 들어간다.</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code>    <span class="n">proj</span> <span class="n">from</span> <span class="o">=</span> <span class="n">psi_1_dual_source</span><span class="p">,</span> <span class="n">from0</span> <span class="o">=</span> <span class="n">psi_1_dual_source</span><span class="p">;</span>
    <span class="n">proj</span> <span class="n">to</span> <span class="o">=</span> <span class="n">phi_2_adjusted_target</span><span class="p">;</span> <span class="c1">// phi_2 source</span>
    <span class="n">two_walk_long</span> <span class="n">phi_2_dual_eta</span><span class="p">;</span>
    <span class="n">init_trivial_two_walk_long</span><span class="p">(</span><span class="o">&amp;</span><span class="n">phi_2_dual_eta</span><span class="p">);</span>

    <span class="k">if</span> <span class="p">(</span><span class="n">dist</span> <span class="o">&gt;</span> <span class="mi">0</span><span class="p">)</span> <span class="p">{</span>
        <span class="kt">bool</span> <span class="n">done</span><span class="p">;</span>
        <span class="n">assert</span><span class="p">(</span><span class="n">dist</span> <span class="o">!=</span> <span class="mi">1</span><span class="p">);</span> <span class="c1">// for now, the case dist == 1 crashes</span>
        <span class="n">done</span> <span class="o">=</span> <span class="n">MITM2</span><span class="p">(</span><span class="o">&amp;</span><span class="n">eta</span><span class="p">,</span> <span class="o">&amp;</span><span class="n">from</span><span class="p">,</span> <span class="o">&amp;</span><span class="n">to</span><span class="p">,</span> <span class="n">dist</span><span class="p">);</span>
        <span class="n">assert</span><span class="p">(</span><span class="n">done</span><span class="p">);</span>
        <span class="n">two_walk_composition_ss</span><span class="p">(</span><span class="o">&amp;</span><span class="n">phi_2_dual_eta</span><span class="p">,</span> <span class="o">&amp;</span><span class="n">phi_2_dual</span><span class="p">,</span> <span class="o">&amp;</span><span class="n">eta</span><span class="p">);</span>
    <span class="p">}</span>
    <span class="k">else</span> <span class="p">{</span>
        <span class="n">two_walk_stol</span><span class="p">(</span><span class="o">&amp;</span><span class="n">phi_2_dual_eta</span><span class="p">,</span> <span class="o">&amp;</span><span class="n">phi_2_dual</span><span class="p">);</span>
    <span class="p">}</span>
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">psi_1</code>과 <code class="language-plaintext highlighter-rouge">phi_2</code>를 얻은 후, <code class="language-plaintext highlighter-rouge">psi_1</code>의 codomain curve <code class="language-plaintext highlighter-rouge">from</code>과 <code class="language-plaintext highlighter-rouge">phi_2</code>의 codomain curve <code class="language-plaintext highlighter-rouge">to</code> 사이에 degree가 $2^\Delta$인 isogeny를 <code class="language-plaintext highlighter-rouge">MITM</code> 함수를 이용해 meet-in-the-middle 방식으로 찾는다. 이렇게 찾은 $2^\Delta$-degree isogeny가 <code class="language-plaintext highlighter-rouge">eta</code>이다.</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code>    <span class="n">phi_L</span><span class="o">-&gt;</span><span class="n">source</span> <span class="o">=</span> <span class="n">global_setup</span><span class="p">.</span><span class="n">E0</span><span class="p">;</span>
    <span class="n">phi_L</span><span class="o">-&gt;</span><span class="n">phi1</span> <span class="o">=</span> <span class="n">psi_2</span><span class="p">;</span>

    <span class="n">phi_L</span><span class="o">-&gt;</span><span class="n">phi2_dual_set</span> <span class="o">=</span> <span class="nb">false</span><span class="p">;</span>

    <span class="c1">// since psi_1_dual has already been computed...</span>
    <span class="n">phi_L</span><span class="o">-&gt;</span><span class="n">middle</span> <span class="o">=</span> <span class="n">psi_1_dual_source</span><span class="p">;</span> <span class="c1">// = psi_1_dual_source</span>
    <span class="n">phi_L</span><span class="o">-&gt;</span><span class="n">phi2</span> <span class="o">=</span> <span class="n">push_odd_isogeny_through_two_walk_long</span><span class="p">(</span><span class="o">&amp;</span><span class="n">psi_1_dual</span><span class="p">,</span> <span class="o">&amp;</span><span class="n">phi_L</span><span class="o">-&gt;</span><span class="n">middle</span><span class="p">,</span> <span class="o">&amp;</span><span class="n">phi_2_dual_eta</span><span class="p">);</span>

    <span class="n">phi_L</span><span class="o">-&gt;</span><span class="n">phi2_set</span> <span class="o">=</span> <span class="nb">true</span><span class="p">;</span>
</code></pre></div></div>

<p>그 다음엔 <code class="language-plaintext highlighter-rouge">psi_1_dual</code>을 <code class="language-plaintext highlighter-rouge">phi_2_dual_eta</code>를 통해 push forward하고, 이를 <code class="language-plaintext highlighter-rouge">phi_L-&gt;phi2</code>에 저장한다. 이는 2의 지수승 degree를 갖는 isogeny를 연산하는 것이므로 연산량이 많지 않다. ideal <code class="language-plaintext highlighter-rouge">L_</code>에 대응되는 isogeny $\phi_L$은 위 코드와 같이 <code class="language-plaintext highlighter-rouge">phi_L-&gt;phi1 = psi_2</code>와 <code class="language-plaintext highlighter-rouge">phi_L-&gt;phi2</code>의 합성으로 구성됨을 알 수 있다.</p>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="PQCrypto" /><summary type="html"><![CDATA[Deuring Correspondence에 의하면 Isogeny와 Ideal은 대응관계에 있다. Supersingular elliptic curve $E$에 대해서 maximal order $\mathcal{O}$에 대해 $\mathrm{End}(E) \cong \mathcal{O}$를 만족할 때, $E$를 codomain으로 가지는 isogeny $\phi:E \rightarrow E’$은 left $\mathcal{O}$-ideal $I$에 대응된다. Isogeny 기반 서명 기법인 SQISign에서 서명 시 가장 오래걸리는 부분이 바로 $\mathcal{l}^e$-Ideal을 Isogeny로 변환하는 과정이다.]]></summary></entry><entry><title type="html">Non-constant Morphism of Curves is surjective</title><link href="https://gusgkr0117.github.io/2021/02/18/Non-Constant-Morphism-of-Curves-is-Surjective.html" rel="alternate" type="text/html" title="Non-constant Morphism of Curves is surjective" /><published>2021-02-18T00:00:00+09:00</published><updated>2021-02-18T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2021/02/18/Non-Constant-Morphism-of-Curves-is-Surjective</id><content type="html" xml:base="https://gusgkr0117.github.io/2021/02/18/Non-Constant-Morphism-of-Curves-is-Surjective.html"><![CDATA[<ul>
  <li>
    <p>해당 글은 Fulton의 <a href="http://www.math.lsa.umich.edu/~wfulton/CurveBook.pdf">Algebraic Curves</a>와 Silverman의 <a href="https://www.springer.com/gp/book/9780387094939">Arithmetic of Elliptic Curves</a>를 정리한 것이다.</p>
  </li>
  <li>
    <p>Finite field $\mathbb{F}_p$ 위에서 정의된 두 Elliptic Curve $C_1, C_2$의 점 개수가 같으면 두 Curve는 isogenous 임이 알려져있다. degree가 1보다 큰 isogeny를 적용했을 때 점 개수가 줄어듦이 명확하고, 따라서 <a href="https://math.stackexchange.com/questions/2969598/if-isogenous-elliptic-curves-have-equal-numbers-of-points-how-can-isogenies-hav">surjective가 아니게 되는 문제에 대한 의문</a>을 해결한다.</p>
  </li>
</ul>

<h2 id="dimension-of-a-curve">Dimension of a curve</h2>

<p>Variety $V$의 dimension은 function field $K(V)$를 field extension of $K$라고 생각했을 때, 해당 extension의 transcendence degree를 말한다. transcendence degree는 algebraic 하게 generate되지 않는 extension field 위의 원소들의 dimension을 뜻한다. transcendence degree가 $n$이면, algebraic basis의 개수는 $n$개가 된다.</p>

<p>Curve $C$는 dimension이 1인 variety로 정의된다. 따라서 $K(C)$의 transcendence degree가 1이라는 의미이다. algebraic basis는 한 개이고, 이를 $t \in K(C) \setminus K$라고 하자. 그러면 $K(C)$는 $K(t)$에 대한 algebraic field extension(finite field extension)이다.</p>

<h2 id="any-proper-closed-subvariety-of-a-curve-is-a-point">Any proper closed subvariety of a curve is a point</h2>

<p>curve 위에서 어떤 proper closed subvariety(아직 zariski topology를 정리하지 않았으므로 여기서는 간단히 affine variety를 생각하자)는 항상 점 한개로 구성됨을 증명하자. 아래 두 개의 claim을 거쳐야 한다.</p>

<h5 id="claim-1-k가-algebraically-closed-이면-임의의-원소-x-in-kc-setminus-k에-대해-kc는-kx에-대한-algebraic-field-extension이다fulton-6-proposition-91">Claim 1. $K$가 algebraically closed 이면, 임의의 원소 $x \in K(C) \setminus K$에 대해 $K(C)$는 $K(x)$에 대한 algebraic field extension이다.(Fulton 6. Proposition 9(1))</h5>

<p><em>Proof)</em> algebraic basis를 $t \in K(C) \setminus K$라고 하자. 임의의 원소 $x \in K(C) \setminus K$에 대하여 minimal polynomial $f = \sum_{i,j} a_{ij} t^i X^j \in K(t)[X]$가 존재해서 $\sum_{i,j} a_{ij} t^i x^j = 0$을 만족한다. 여기서 <font color="red">$K$가 algebraically closed</font>인 경우, $x$는 $K$ 위의 algebraic number가 될 수 없다. 따라서 polynomial $f(t,x)$는 t에 대한 polynomial이 되어 $t$는 $x$로부터 algebraically 생성된다.</p>

<div style="text-align: right">□</div>

<h5 id="claim-2-k가-algebraically-closed이고-ring-r이-존재해서-quotient-field-kc를-갖는다고-하면-r-위의-prime-ideal-i에-대해-항상-ri-cong-k이다fulton-6-proposition-93">Claim 2. $K$가 algebraically closed이고, Ring $R$이 존재해서 quotient field $K(C)$를 갖는다고 하면, $R$ 위의 prime ideal $I$에 대해 항상 $R/I \cong K$이다.(Fulton 6. Proposition 9(3))</h5>

<p><em>Proof)</em> 귀류법으로 $R/I$ 상에서 $K$에 포함되지 않는 $x$가 존재한다고 가정하자. 그러면 <strong>Claim 1.</strong> 에 의해서 $K(C)$는 $K(x)$에 대한 algebraic field extension이다. 그러면 $y \in I$에 대해 minimal polynomial $f = \sum_{i} a_{i}(x)X^i \in K(x)[X]$가 존재해서 $\sum_{i} a_{i}(x) y^i = 0$을 만족한다. 
$f$는 minimal polynomial이므로 $a_0(x) \neq 0$이다. quotient ring $R/I$ 상에서 $f(y) = a_0(x) = 0$이 된다. 이는 $x$가 $K$에 대해 algebraic하다는 의미로 모순이다. 따라서 이러한 $x$가 존재하지 않는다.</p>

<div style="text-align: right">□</div>

<p>이제 <strong>Claim 2.</strong> 를 이용해 아래의 <strong>Proposition 3.</strong> 을 증명할 것이다.</p>

<h5 id="proposition-3-k가-algebraically-closed-일-때-curve-위에-존재하는-모든-proper-closed-subvariety-점-하나로-구성된다fulton-6-proposition-104">Proposition 3. $K$가 algebraically closed 일 때, Curve 위에 존재하는 모든 proper closed subvariety 점 하나로 구성된다.(Fulton 6. Proposition 10(4))</h5>

<p><em>Proof)</em> Curve $C$에 대한 coordinate ring $K[C]$를 생각하자. curve 위의 closed subvariety $W \subset C$는 $K[C]$에 속하는 prime ideal $I \subset K[C]$에 대응된다. <strong>Claim 2.</strong> 에 의해 $K[C]/I \cong K$ 임을 알고 있다. 이는 subvariety W에 대한 coordinate ring $K[W]$와 isomorphic하다. 따라서 subvariety $W$는 Curve $C$ 위의 한 점이 된다.</p>

<div style="text-align: right">□</div>

<h2 id="non-constant-morphism-of-curves-is-surjective">Non-constant morphism of curves is surjective</h2>

<p>Morphism $\varphi: C_1 \rightarrow C_2$는 zariski topology 상에서 continuous하다. $C_2$는 curve이므로 <strong>Proposition 3.</strong> 에 의해 $C_2$ 위의 proper closed subvariety는 하나의 점으로 구성된다. morphism은 $C_1$ 위의 모든 점에서 define되며, $C_1$은 closed subvariety이므로 morphism $\varphi$의 image는 하나의 점이거나 Curve $C_2$ 전체가 된다. 따라서 constant이거나 surjective인 것이다!</p>

<h2 id="degree-of-a-morphism">Degree of a morphism</h2>

<p>non-constant morphism은 surjective이다. 또한 morphism $\varphi$에 대한 induced map $\tilde{\varphi}: K(C_2) \rightarrow K(C_1)$을 생각했을 때, $\tilde{\varphi}(K(C_2))$는 transcendence degree 1을 갖는다. 따라서 $K(C_1)$은 $\tilde{\varphi}(K(C_2))$에 대한 algebraic field extension이 되며, 아래와 같이 extension degree를 morphism의 degree로 정의할 수 있다.</p>

<center>$deg(\varphi) = [K(C_1):\tilde{\varphi}(K(C_2))]$</center>

<p>해당 degree는 isogeny에서 group homomorphism의 degree 정의와 유사한 의미를 갖는다. group homomorphism에서는 kernel의 크기로 degree를 정하기 때문에 inseparable degree가 표현되지 않지만, 위와 같이 정의된 morphism의 degree는 inseparable degree를 반영한다.(inseparable degree를 가지려면 field $K$의 characteristic이 0보다 커야하며, 이에 대한 algebraic closure $\bar{\mathbb{F}}_p$를 생각한다.)</p>

<h2 id="curves-on-a-finite-field">Curves on a finite field</h2>

<p>Finite field $\mathbb{F}_p$ 위에서 정의된 두 Elliptic Curve $C_1, C_2$의 점 개수가 같으면 두 Curve는 isogenous 임이 알려져있다. degree가 1보다 큰 isogeny를 적용했을 때 점 개수가 줄어듦이 명확하고, 따라서 <a href="https://math.stackexchange.com/questions/2969598/if-isogenous-elliptic-curves-have-equal-numbers-of-points-how-can-isogenies-hav">surjective가 아니게 되는 문제에 대한 의문</a>이 발생한다.</p>

<blockquote>
  <p>사실 이 문제가 머릿속에서 해결이 안되서 포스트로 정리해 본 것이었다. 하지만 생각보다 간단한 문제였던 것 같다..</p>
</blockquote>

<p>이러한 오류가 발생하는 원인은 Finite field $\mathbb{F}_p$ 위에서 우리가 생각하는 일반적인 Curve들이 irreducible하지 않다는 것을 간과한 것이다. Finite field에서는 모든 algebraic set들이 finite 개수의 점을 갖는다. 각각의 점은 variety이기 때문에 variety의 유한 합으로 표현 가능하고, 당연히도 irreducible하지 않게 된다.</p>

<p>variety는 한 점으로만 구성되며, 이러한 점은 coordinate ring이 $\mathbb{F}_p$와 같아져서 dimension이 0이기 때문에 curve가 존재하지 않는다고 볼 수 있다. curve 개념이 생기기 위해서는 field의 원소 개수가 무한해야하며, algebraic closure of finite field $\bar{\mathbb{F}}_p$ 위에서 생각해야할 것이다. 여기서는 curve가 존재하기 때문에 non-constant morphism of curves가 surjective임을 사용할 수 있다.
또한 p-adic field $\mathbb{Q}_p$에서도 마찬가지로 사용할 수 있다.</p>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Mathematics" /><summary type="html"><![CDATA[해당 글은 Fulton의 Algebraic Curves와 Silverman의 Arithmetic of Elliptic Curves를 정리한 것이다. Finite field $\mathbb{F}_p$ 위에서 정의된 두 Elliptic Curve $C_1, C_2$의 점 개수가 같으면 두 Curve는 isogenous 임이 알려져있다. degree가 1보다 큰 isogeny를 적용했을 때 점 개수가 줄어듦이 명확하고, 따라서 surjective가 아니게 되는 문제에 대한 의문을 해결한다. Dimension of a curve Variety $V$의 dimension은 function field $K(V)$를 field extension of $K$라고 생각했을 때, 해당 extension의 transcendence degree를 말한다. transcendence degree는 algebraic 하게 generate되지 않는 extension field 위의 원소들의 dimension을 뜻한다. transcendence degree가 $n$이면, algebraic basis의 개수는 $n$개가 된다. Curve $C$는 dimension이 1인 variety로 정의된다. 따라서 $K(C)$의 transcendence degree가 1이라는 의미이다. algebraic basis는 한 개이고, 이를 $t \in K(C) \setminus K$라고 하자. 그러면 $K(C)$는 $K(t)$에 대한 algebraic field extension(finite field extension)이다. Any proper closed subvariety of a curve is a point curve 위에서 어떤 proper closed subvariety(아직 zariski topology를 정리하지 않았으므로 여기서는 간단히 affine variety를 생각하자)는 항상 점 한개로 구성됨을 증명하자. 아래 두 개의 claim을 거쳐야 한다. Claim 1. $K$가 algebraically closed 이면, 임의의 원소 $x \in K(C) \setminus K$에 대해 $K(C)$는 $K(x)$에 대한 algebraic field extension이다.(Fulton 6. Proposition 9(1)) Proof) algebraic basis를 $t \in K(C) \setminus K$라고 하자. 임의의 원소 $x \in K(C) \setminus K$에 대하여 minimal polynomial $f = \sum_{i,j} a_{ij} t^i X^j \in K(t)[X]$가 존재해서 $\sum_{i,j} a_{ij} t^i x^j = 0$을 만족한다. 여기서 $K$가 algebraically closed인 경우, $x$는 $K$ 위의 algebraic number가 될 수 없다. 따라서 polynomial $f(t,x)$는 t에 대한 polynomial이 되어 $t$는 $x$로부터 algebraically 생성된다. □ Claim 2. $K$가 algebraically closed이고, Ring $R$이 존재해서 quotient field $K(C)$를 갖는다고 하면, $R$ 위의 prime ideal $I$에 대해 항상 $R/I \cong K$이다.(Fulton 6. Proposition 9(3)) Proof) 귀류법으로 $R/I$ 상에서 $K$에 포함되지 않는 $x$가 존재한다고 가정하자. 그러면 Claim 1. 에 의해서 $K(C)$는 $K(x)$에 대한 algebraic field extension이다. 그러면 $y \in I$에 대해 minimal polynomial $f = \sum_{i} a_{i}(x)X^i \in K(x)[X]$가 존재해서 $\sum_{i} a_{i}(x) y^i = 0$을 만족한다. $f$는 minimal polynomial이므로 $a_0(x) \neq 0$이다. quotient ring $R/I$ 상에서 $f(y) = a_0(x) = 0$이 된다. 이는 $x$가 $K$에 대해 algebraic하다는 의미로 모순이다. 따라서 이러한 $x$가 존재하지 않는다. □ 이제 Claim 2. 를 이용해 아래의 Proposition 3. 을 증명할 것이다. Proposition 3. $K$가 algebraically closed 일 때, Curve 위에 존재하는 모든 proper closed subvariety 점 하나로 구성된다.(Fulton 6. Proposition 10(4)) Proof) Curve $C$에 대한 coordinate ring $K[C]$를 생각하자. curve 위의 closed subvariety $W \subset C$는 $K[C]$에 속하는 prime ideal $I \subset K[C]$에 대응된다. Claim 2. 에 의해 $K[C]/I \cong K$ 임을 알고 있다. 이는 subvariety W에 대한 coordinate ring $K[W]$와 isomorphic하다. 따라서 subvariety $W$는 Curve $C$ 위의 한 점이 된다. □ Non-constant morphism of curves is surjective Morphism $\varphi: C_1 \rightarrow C_2$는 zariski topology 상에서 continuous하다. $C_2$는 curve이므로 Proposition 3. 에 의해 $C_2$ 위의 proper closed subvariety는 하나의 점으로 구성된다. morphism은 $C_1$ 위의 모든 점에서 define되며, $C_1$은 closed subvariety이므로 morphism $\varphi$의 image는 하나의 점이거나 Curve $C_2$ 전체가 된다. 따라서 constant이거나 surjective인 것이다! Degree of a morphism non-constant morphism은 surjective이다. 또한 morphism $\varphi$에 대한 induced map $\tilde{\varphi}: K(C_2) \rightarrow K(C_1)$을 생각했을 때, $\tilde{\varphi}(K(C_2))$는 transcendence degree 1을 갖는다. 따라서 $K(C_1)$은 $\tilde{\varphi}(K(C_2))$에 대한 algebraic field extension이 되며, 아래와 같이 extension degree를 morphism의 degree로 정의할 수 있다. $deg(\varphi) = [K(C_1):\tilde{\varphi}(K(C_2))]$ 해당 degree는 isogeny에서 group homomorphism의 degree 정의와 유사한 의미를 갖는다. group homomorphism에서는 kernel의 크기로 degree를 정하기 때문에 inseparable degree가 표현되지 않지만, 위와 같이 정의된 morphism의 degree는 inseparable degree를 반영한다.(inseparable degree를 가지려면 field $K$의 characteristic이 0보다 커야하며, 이에 대한 algebraic closure $\bar{\mathbb{F}}_p$를 생각한다.) Curves on a finite field Finite field $\mathbb{F}_p$ 위에서 정의된 두 Elliptic Curve $C_1, C_2$의 점 개수가 같으면 두 Curve는 isogenous 임이 알려져있다. degree가 1보다 큰 isogeny를 적용했을 때 점 개수가 줄어듦이 명확하고, 따라서 surjective가 아니게 되는 문제에 대한 의문이 발생한다. 사실 이 문제가 머릿속에서 해결이 안되서 포스트로 정리해 본 것이었다. 하지만 생각보다 간단한 문제였던 것 같다.. 이러한 오류가 발생하는 원인은 Finite field $\mathbb{F}_p$ 위에서 우리가 생각하는 일반적인 Curve들이 irreducible하지 않다는 것을 간과한 것이다. Finite field에서는 모든 algebraic set들이 finite 개수의 점을 갖는다. 각각의 점은 variety이기 때문에 variety의 유한 합으로 표현 가능하고, 당연히도 irreducible하지 않게 된다. variety는 한 점으로만 구성되며, 이러한 점은 coordinate ring이 $\mathbb{F}_p$와 같아져서 dimension이 0이기 때문에 curve가 존재하지 않는다고 볼 수 있다. curve 개념이 생기기 위해서는 field의 원소 개수가 무한해야하며, algebraic closure of finite field $\bar{\mathbb{F}}_p$ 위에서 생각해야할 것이다. 여기서는 curve가 존재하기 때문에 non-constant morphism of curves가 surjective임을 사용할 수 있다. 또한 p-adic field $\mathbb{Q}_p$에서도 마찬가지로 사용할 수 있다.]]></summary></entry><entry><title type="html">Variety and Morphism</title><link href="https://gusgkr0117.github.io/2021/02/17/Variety-and-Morphism.html" rel="alternate" type="text/html" title="Variety and Morphism" /><published>2021-02-17T00:00:00+09:00</published><updated>2021-02-17T00:00:00+09:00</updated><id>https://gusgkr0117.github.io/2021/02/17/Variety-and-Morphism</id><content type="html" xml:base="https://gusgkr0117.github.io/2021/02/17/Variety-and-Morphism.html"><![CDATA[<ul>
  <li>
    <p>해당 글은 Silverman의 <a href="https://www.springer.com/gp/book/9780387094939">Arithmetic of Elliptic Curves</a>의 Chapter 1을 정리한 것이다.</p>
  </li>
  <li>
    <p>Diopantine equation은 $ax + by = c$를 만족하는 정수해 $x, y$를 찾는 것을 말한다. 만약 2차 다항식이거나 변수가 $x,y$가 아니라 $x_1, x_2, …, x_n$으로 많다면 정수해를 어떻게 찾을 수 있을까? 그리고 그들은 어떤 특징을 가질까?</p>
  </li>
  <li>
    <p>다항식을 통해 얻을 수 있는 점들의 집합은 대수적으로 어떤 특성을 갖는지 분석하는 것이 대수기하학이다. 이것의 기본이 되는 기념이 algebraic set, variety라고 할 수 있다.</p>
  </li>
  <li>Notation
    <ul>
      <li>$K$ : field</li>
      <li>$\bar{K}$ : algebraic closure of $K$</li>
      <li>$G_{\bar{K}/K}$ : Galois group of $\bar{K}/K$</li>
    </ul>
  </li>
  <li>
    <p>$K[X_1, X_2, … , X_n]$는 간단히 $K[X]$로 표기하도록 하겠다.</p>
  </li>
  <li>Affine Space
    <ul>
      <li>$\mathbb{A}^n = \{(y_1, y_2, …, y_n) : y_i \in \bar{K} \ \textrm{for} \ 1 \leq i \leq n\}$</li>
      <li>$\mathbb{A}^n(K) = \{(y_1, y_2, …, y_n) : y_i \in K \ \textrm{for} \ 1 \leq i \leq n\}$</li>
    </ul>
  </li>
</ul>

<h2 id="algebraic-set">Algebraic set</h2>

<p>$\bar{K}[X]$ 상의 ideal $I \subset \bar{K}[X]$가 주어졌을 때, algebraic set $V_I$는 아래와 같이 정의된다.</p>

<center>$V_I = \{ P \in \mathbb{A}^n : f(P) = 0 \ \textrm{for} \ \forall f \in I \}$</center>

<p>algebraic set $V_I$는 일반적으로 $V$로 생략해서 표기한다. $I(V)$가 만일 $K[X]$에 들어있는 함수들로 generate 된다면, $V$는 $K$ 위에서 정의되었다고 하며 이를 $V/K$라고 표기한다. $V(K)$는 $V$에 속하는 점들 중에서 $K$ 위에서 정의된 점들을 말하며 아래와 같이 정의된다.</p>

<center>$V(K) = V \cap \mathbb{A}^n(K)$</center>

<p>또한 $I(K) = I(V) \cap K[X] \subset \bar{K}[X]$로 정의한다. 정의에 따르면 $V/K$에 대해 아래와 같은 식을 도출 할 수 있다.</p>

<center>$I(V) = I(K)\bar{K}[X]$ &nbsp;&nbsp;if $V$ is defined over $K$</center>

<h3 id="variety">Variety</h3>

<p>variety란, algebraic set $V$에 대해 $I(V) \subset \bar{K}[X]$가 <strong><font color="red">prime ideal이면 $V$를 variety라고 한다.</font></strong></p>

<p>$\bar{K}$는 field이므로 noetherian이다. <a href="https://en.wikipedia.org/wiki/Hilbert%27s_basis_theorem">Hilbert basis theorem</a>에 의해 $\bar{K}[X]$도 따라서 noetherian이다. 따라서 $\bar{K}[X]$에 속하는 ideal들은 prime ideal의 곱으로 unique하게 표현할 수 있다. 이와 마찬가지로 algebraic set $V$는 variety들의 union으로 아래와 같이 유일하게 표현된다.</p>

<center>$V = V_1 \cup V_2 \cup ... \cup V_n$ where $V_i$ is variety</center>

<p>ideal $J$가 주어졌을 때, $I(V(J))$은 사실 $Rad(J) = \{f : f^m \in J \ \textrm{for some} \ m \in \mathbb{Z}^+ \cup \{ 0 \}\}$와 같다. 따라서 위와 같이 variety의 union에서는 제곱식이 표현이 안되는 것이다.</p>

<h3 id="coordinate-ring-and-function-field">Coordinate ring and function field</h3>

<p>algebraic set $V$가 주어지면 $\bar{K}[X]/I(V)$를 Coordinate ring이라고 하고, $\bar{K}[V]$로 표기한다. $V$가 variety이면, $I(V)$가 prime ideal이고, $\bar{K}[V]$는 integral domain이 되며, quotient field(field of fraction)을 정의할 수 있다. 이를 $\bar{K}(V)$로 표기하고, function field라고 부른다.</p>

<p>만약에 variety $V$가 $K$ 위에서 정의되었다면, Galois group $G_{\bar{K}/K}$에 의해 $I(V)$는 $I(V)$로 그대로 맵핑된다. 따라서 $\bar{K}[V], \bar{K}(V)$에 있는 원소에 대해서 Galois group은 obvious하게 동작한다. 이 말은 $f \in \bar{K}[V]$와 $\sigma \in G_{\bar{K}/K}$에 대해 $f^{\sigma}$는 $I(V)$를 신경쓰지 않고, group action을 수행해도 된다는 의미이다.</p>

<p>$\dim(V)$는 $\bar{K}[V]$의 $\bar{K}$ 위에서 <a href="https://en.wikipedia.org/wiki/Transcendence_degree">transcendence degree</a>를 말한다. 예를 들어, $V : f(x_1, …, x_n) = 0$ 일 때, $f$가 non-constant function이면, $\bar{K}[X]/ \left&lt; f \right&gt;$는 algebraic basis가 $n-1$개 이므로 $\dim(V) = n-1$임을 알 수 있다.</p>

<p><strong><font color="red">function field $\bar{K}(V)$의 원소는 맵핑 $f: V \rightarrow \bar{K}$로 obvious하게 대응됨을 알 수 있다.</font></strong> 이게 굉장히 재미있는 부분인데, algebraic set $V$에 있는 점 각각을 $\bar{K}$로 임의로 맵핑하는 것은 사실 $\bar{K}(V)$에 속하지 않을 수도 있다. $\bar{K}(V)$는 polynomial 특성(?)을 가지는 맵핑 $V \rightarrow \bar{K}$에 관한 정보를 담고 있다고 볼 수 있다.</p>

<center>
<figure>
<img src="/assets/20210217/20210217_1.png" width="70%" />
<figcaption>
$\mathbb{R}^2$ 위의 algebraic set에 대한 function field의 예시<br />$f: C \rightarrow \mathbb{R}$ where $C : Y=X^3 - 4X^2 + X + 6 \subset \mathbb{R}^2$
</figcaption>
</figure>
</center>

<h2 id="projective-space">Projective space</h2>

<p>우리가 위에서 사용했던 $\mathbb{A}^n$은 Affine space라고 부른다. Projective space $\mathbb{P}^n$은 아래와 같이 정의된다.</p>

<center>$\mathbb{P}^n = \mathbb{A}^{n+1}/\sim$</center>

<p>relation $\sim$는 $(y_1, …, y_{n+1}) \sim (y_1^{\prime}, …, y_{n+1}^{\prime})$이면 $(y_1, …, y_{n+1}) = (\lambda y_1^{\prime}, …, \lambda y_{n+1}^{\prime})$ for some $\lambda \in \bar{K}$를 의미한다.</p>

<blockquote>
  <p>projective space를 사용하면 평행인 직선도 결국 point at infinity에서 만남을 알 수 있다. 그러면 rough하게 $n$차 다항식과 $m$차 다항식이 둘다 nonsingular인 경우에 prjective space 위에서 $nm$개의 점에서 만남을 추론할 수 있다.(<a href="https://en.wikipedia.org/wiki/B%C3%A9zout%27s_theorem">Bezout’s theorem</a>) 이와 같은 특성을 사용하게 위해 projective space를 사용한다.</p>
</blockquote>

<p>projective algebraic set $V$는 homogeneous 함수들로 generate되는 ideal $I \in \bar{K}[X_1, …, X_{n+1}]$로부터 정의되며, $I(V)$ 또한 homogeneous 함수들로 generate되는 ideal을 말한다. 아래와 같은 subset을 이용하면 projective set $\mathbb{P}^n$과 affine set $\mathbb{A}^n$을 연결할 수 있다.</p>

<center>$U_i = \{ [y_1/y_i, ..., 1, ..., y_{n+1}/y_i] \in \mathbb{P}^n : y_i \neq 0 \}$</center>

<p>$\phi_i : U_i \rightarrow \mathbb{A}^{n}$인 one-to-one map을 obvious하게 정의할 수 있다. 그러면 아래와 같은 조건을 만족한다.</p>

<center>$\mathbb{P}^n = \phi_1^{-1}(\mathbb{A}^n) \cup ... \cup \phi_{n+1}^{-1}(\mathbb{A}^n)$</center>

<p>projective algebraic set $V$가 주어졌을 때, 이를 affine space에서 바라본다면, $\phi_i(V \cap U_i)$가 되고, $V - U_i$에 속하는 점들을 point at infinity라고 부른다.</p>

<blockquote>
  <p>Elliptic Curve Cryptography에서 사용하는 그 point at infinity의 개념이 여기서 나온 것이다.</p>
</blockquote>

<p>affine algebraic set $V$이 주어지면 $I(V)$를 찾을 수 있고, 이 것의 generator set $\{f_1, …, f_m\} \subset \bar{K}[X_1, …, X_n]$을 찾을 수 있다.($\bar{K}[X]$는 noetherian이므로 finitely generate된다.) 해당 generator들을 homogenization 시키면, $\{ f_1^{\ast}, …,f_m^{\ast} \} \subset \bar{K}[X_1, …, X_{n+1}]$가 되고, 이들을 통해 generate되는 ideal로 만들어지는 projective algebraic set $V’$을 생각할 수 있다. 이렇게 만들어진 projective algebraic set은 $V = \phi_{n+1}(V’ \cap U_{n+1})$을 만족한다.</p>

<p>따라서 우리는 projective algebraic set $V \in \mathbb{P}^n$이 주어지면 이를 affine algebraic set으로 표현할 수 있고, 이는 곧 dehomogenization된 polynomial $\in \bar{K}[X_1, …,X_n]$으로 표현할 수 있다!</p>

<h2 id="rational-map-and-morphism">Rational map and Morphism</h2>

<p>두 개의 projective variety $V_1 \in \mathbb{P}^n$과 $V_2 \in \mathbb{P}^m$이 주어졌을 때, 아래와 같은 map을 생각하자.</p>

<center>$\varphi : V_1 \rightarrow V_2$ where $\varphi(P) = [f_1(P), ..., f_{m+1}(P)]$ for $P \in V_1$, $f_i \in \bar{K}(V)$</center>

<p>이렇게 정의된 mapping은 well-define되며, rational map이라고 부른다. rational map의 정의에 따르면, rational map $\varphi$가 모든 점 $P \in V_1$ 위에서 정의될 필요는 없다. 모든 점 $P \in V_1$ 위에서 정의된다면 이러한 rational map을 morphism이라고 부른다.</p>

<blockquote>
  <p>이런식으로 morphism을 정의하면 rational map은 variety topology(<a href="https://en.wikipedia.org/wiki/Zariski_topology">zariski topology</a>)에 대한 continuous function이 된다!</p>
</blockquote>

<p>projective variety $V_1, V_2$에 대해 두 morphism $\psi : V_1 \rightarrow V_2$와 $\varphi : V_2 \rightarrow V_1$가 존재해서, $\psi \circ \varphi$와 $\varphi \circ \psi$가 identity가 되면 $V_1, V_2$는 isomorphic하다고 한다.</p>]]></content><author><name>manbo</name><email>gusgkr0117@korea.ac.kr</email></author><category term="Mathematics" /><summary type="html"><![CDATA[해당 글은 Silverman의 Arithmetic of Elliptic Curves의 Chapter 1을 정리한 것이다. Diopantine equation은 $ax + by = c$를 만족하는 정수해 $x, y$를 찾는 것을 말한다. 만약 2차 다항식이거나 변수가 $x,y$가 아니라 $x_1, x_2, …, x_n$으로 많다면 정수해를 어떻게 찾을 수 있을까? 그리고 그들은 어떤 특징을 가질까? 다항식을 통해 얻을 수 있는 점들의 집합은 대수적으로 어떤 특성을 갖는지 분석하는 것이 대수기하학이다. 이것의 기본이 되는 기념이 algebraic set, variety라고 할 수 있다. Notation $K$ : field $\bar{K}$ : algebraic closure of $K$ $G_{\bar{K}/K}$ : Galois group of $\bar{K}/K$ $K[X_1, X_2, … , X_n]$는 간단히 $K[X]$로 표기하도록 하겠다. Affine Space $\mathbb{A}^n = \{(y_1, y_2, …, y_n) : y_i \in \bar{K} \ \textrm{for} \ 1 \leq i \leq n\}$ $\mathbb{A}^n(K) = \{(y_1, y_2, …, y_n) : y_i \in K \ \textrm{for} \ 1 \leq i \leq n\}$ Algebraic set $\bar{K}[X]$ 상의 ideal $I \subset \bar{K}[X]$가 주어졌을 때, algebraic set $V_I$는 아래와 같이 정의된다. $V_I = \{ P \in \mathbb{A}^n : f(P) = 0 \ \textrm{for} \ \forall f \in I \}$ algebraic set $V_I$는 일반적으로 $V$로 생략해서 표기한다. $I(V)$가 만일 $K[X]$에 들어있는 함수들로 generate 된다면, $V$는 $K$ 위에서 정의되었다고 하며 이를 $V/K$라고 표기한다. $V(K)$는 $V$에 속하는 점들 중에서 $K$ 위에서 정의된 점들을 말하며 아래와 같이 정의된다. $V(K) = V \cap \mathbb{A}^n(K)$ 또한 $I(K) = I(V) \cap K[X] \subset \bar{K}[X]$로 정의한다. 정의에 따르면 $V/K$에 대해 아래와 같은 식을 도출 할 수 있다. $I(V) = I(K)\bar{K}[X]$ &nbsp;&nbsp;if $V$ is defined over $K$ Variety variety란, algebraic set $V$에 대해 $I(V) \subset \bar{K}[X]$가 prime ideal이면 $V$를 variety라고 한다. $\bar{K}$는 field이므로 noetherian이다. Hilbert basis theorem에 의해 $\bar{K}[X]$도 따라서 noetherian이다. 따라서 $\bar{K}[X]$에 속하는 ideal들은 prime ideal의 곱으로 unique하게 표현할 수 있다. 이와 마찬가지로 algebraic set $V$는 variety들의 union으로 아래와 같이 유일하게 표현된다. $V = V_1 \cup V_2 \cup ... \cup V_n$ where $V_i$ is variety ideal $J$가 주어졌을 때, $I(V(J))$은 사실 $Rad(J) = \{f : f^m \in J \ \textrm{for some} \ m \in \mathbb{Z}^+ \cup \{ 0 \}\}$와 같다. 따라서 위와 같이 variety의 union에서는 제곱식이 표현이 안되는 것이다. Coordinate ring and function field algebraic set $V$가 주어지면 $\bar{K}[X]/I(V)$를 Coordinate ring이라고 하고, $\bar{K}[V]$로 표기한다. $V$가 variety이면, $I(V)$가 prime ideal이고, $\bar{K}[V]$는 integral domain이 되며, quotient field(field of fraction)을 정의할 수 있다. 이를 $\bar{K}(V)$로 표기하고, function field라고 부른다. 만약에 variety $V$가 $K$ 위에서 정의되었다면, Galois group $G_{\bar{K}/K}$에 의해 $I(V)$는 $I(V)$로 그대로 맵핑된다. 따라서 $\bar{K}[V], \bar{K}(V)$에 있는 원소에 대해서 Galois group은 obvious하게 동작한다. 이 말은 $f \in \bar{K}[V]$와 $\sigma \in G_{\bar{K}/K}$에 대해 $f^{\sigma}$는 $I(V)$를 신경쓰지 않고, group action을 수행해도 된다는 의미이다. $\dim(V)$는 $\bar{K}[V]$의 $\bar{K}$ 위에서 transcendence degree를 말한다. 예를 들어, $V : f(x_1, …, x_n) = 0$ 일 때, $f$가 non-constant function이면, $\bar{K}[X]/ \left&lt; f \right&gt;$는 algebraic basis가 $n-1$개 이므로 $\dim(V) = n-1$임을 알 수 있다. function field $\bar{K}(V)$의 원소는 맵핑 $f: V \rightarrow \bar{K}$로 obvious하게 대응됨을 알 수 있다. 이게 굉장히 재미있는 부분인데, algebraic set $V$에 있는 점 각각을 $\bar{K}$로 임의로 맵핑하는 것은 사실 $\bar{K}(V)$에 속하지 않을 수도 있다. $\bar{K}(V)$는 polynomial 특성(?)을 가지는 맵핑 $V \rightarrow \bar{K}$에 관한 정보를 담고 있다고 볼 수 있다. $\mathbb{R}^2$ 위의 algebraic set에 대한 function field의 예시$f: C \rightarrow \mathbb{R}$ where $C : Y=X^3 - 4X^2 + X + 6 \subset \mathbb{R}^2$ Projective space 우리가 위에서 사용했던 $\mathbb{A}^n$은 Affine space라고 부른다. Projective space $\mathbb{P}^n$은 아래와 같이 정의된다. $\mathbb{P}^n = \mathbb{A}^{n+1}/\sim$ relation $\sim$는 $(y_1, …, y_{n+1}) \sim (y_1^{\prime}, …, y_{n+1}^{\prime})$이면 $(y_1, …, y_{n+1}) = (\lambda y_1^{\prime}, …, \lambda y_{n+1}^{\prime})$ for some $\lambda \in \bar{K}$를 의미한다. projective space를 사용하면 평행인 직선도 결국 point at infinity에서 만남을 알 수 있다. 그러면 rough하게 $n$차 다항식과 $m$차 다항식이 둘다 nonsingular인 경우에 prjective space 위에서 $nm$개의 점에서 만남을 추론할 수 있다.(Bezout’s theorem) 이와 같은 특성을 사용하게 위해 projective space를 사용한다. projective algebraic set $V$는 homogeneous 함수들로 generate되는 ideal $I \in \bar{K}[X_1, …, X_{n+1}]$로부터 정의되며, $I(V)$ 또한 homogeneous 함수들로 generate되는 ideal을 말한다. 아래와 같은 subset을 이용하면 projective set $\mathbb{P}^n$과 affine set $\mathbb{A}^n$을 연결할 수 있다. $U_i = \{ [y_1/y_i, ..., 1, ..., y_{n+1}/y_i] \in \mathbb{P}^n : y_i \neq 0 \}$ $\phi_i : U_i \rightarrow \mathbb{A}^{n}$인 one-to-one map을 obvious하게 정의할 수 있다. 그러면 아래와 같은 조건을 만족한다. $\mathbb{P}^n = \phi_1^{-1}(\mathbb{A}^n) \cup ... \cup \phi_{n+1}^{-1}(\mathbb{A}^n)$ projective algebraic set $V$가 주어졌을 때, 이를 affine space에서 바라본다면, $\phi_i(V \cap U_i)$가 되고, $V - U_i$에 속하는 점들을 point at infinity라고 부른다. Elliptic Curve Cryptography에서 사용하는 그 point at infinity의 개념이 여기서 나온 것이다. affine algebraic set $V$이 주어지면 $I(V)$를 찾을 수 있고, 이 것의 generator set $\{f_1, …, f_m\} \subset \bar{K}[X_1, …, X_n]$을 찾을 수 있다.($\bar{K}[X]$는 noetherian이므로 finitely generate된다.) 해당 generator들을 homogenization 시키면, $\{ f_1^{\ast}, …,f_m^{\ast} \} \subset \bar{K}[X_1, …, X_{n+1}]$가 되고, 이들을 통해 generate되는 ideal로 만들어지는 projective algebraic set $V’$을 생각할 수 있다. 이렇게 만들어진 projective algebraic set은 $V = \phi_{n+1}(V’ \cap U_{n+1})$을 만족한다. 따라서 우리는 projective algebraic set $V \in \mathbb{P}^n$이 주어지면 이를 affine algebraic set으로 표현할 수 있고, 이는 곧 dehomogenization된 polynomial $\in \bar{K}[X_1, …,X_n]$으로 표현할 수 있다! Rational map and Morphism 두 개의 projective variety $V_1 \in \mathbb{P}^n$과 $V_2 \in \mathbb{P}^m$이 주어졌을 때, 아래와 같은 map을 생각하자. $\varphi : V_1 \rightarrow V_2$ where $\varphi(P) = [f_1(P), ..., f_{m+1}(P)]$ for $P \in V_1$, $f_i \in \bar{K}(V)$ 이렇게 정의된 mapping은 well-define되며, rational map이라고 부른다. rational map의 정의에 따르면, rational map $\varphi$가 모든 점 $P \in V_1$ 위에서 정의될 필요는 없다. 모든 점 $P \in V_1$ 위에서 정의된다면 이러한 rational map을 morphism이라고 부른다. 이런식으로 morphism을 정의하면 rational map은 variety topology(zariski topology)에 대한 continuous function이 된다! projective variety $V_1, V_2$에 대해 두 morphism $\psi : V_1 \rightarrow V_2$와 $\varphi : V_2 \rightarrow V_1$가 존재해서, $\psi \circ \varphi$와 $\varphi \circ \psi$가 identity가 되면 $V_1, V_2$는 isomorphic하다고 한다.]]></summary></entry></feed>