
- 해당 글은 Quantum Security Analysis of CSIDH논문을 정리한 것이다.
- Regev의 알고리즘은 2008년도 A Subexponential Time Algorithm for the DHSP with Polynomial Space 논문을 참조
- Quantum algorithm for HSP 2편
Regev’s algorithm with polynomial quantum space
Kuperberg가 처음 제안했던 알고리즘은 subexponential만큼의 quantum space를 필요로 한다는 단점이 있다. Kuperberg의 combination 방법은 $\frac{1}{2}$ 확률로 실패하기 때문에 $k$개의 labeled state를 결합한다면, 성공 확률은 $\frac{1}{2^{k-1}}$로 줄어든다. 따라서 두개씩만 골라서 2-valuation을 높일 수 있어야하기 때문에 저장공간을 많이 필요로 한다.
Regev는 이러한 단점을 보완하여 여러개의 labeled state를 결합할 수 있는 양자 알고리즘을 제안했다. 물론 Regev의 결합 방법도 실패 확률이 존재하지만, 이는 결합하려는 labeled state의 개수와는 상관 없이 constant 확률을 가지므로 quantum space를 절약할 수 있다.
Regev의 combination 연산은 $l+4$ 개의 labeled state를 입력으로 받아서 $l$ 개의 lsb가 0인 새로운 labeled state를 만든다.
$\newcommand{\ket}[1]{\left| #1 \right>}$ $\newcommand{\bra}[1]{\left< #1 \right|}$ $\newcommand{\norm}[1]{\left| #1 \right|}$ $\newcommand{\inner}[1]{\left< #1 \right>}$ $\newcommand{\ceil}[1]{\lceil #1 \rceil}$ $\newcommand{\floor}[1]{\lfloor #1 \rfloor}$
Combination step
아래와 같은 $l+4$ 개의 labeled state가 주어졌다고 가정하자.
이를 모두 tensor product하면 아래와 같은 quantum state를 얻을 수 있다.
where $\vec{y} = (y_1, y_2, ..., y_{l+4})$
여기서 첫번째 레지스터에 $\ket{\vec{v}}\ket{0} \rightarrow \ket{\vec{v}}\ket{(\inner{\vec{v}, \vec{y}} \mod 2^l)}$연산을 적용하면, 아래와 같은 quantum state를 얻을 수 있다.
여기서 두번째 레지스터를 측정하면 label $V$를 얻고, 아래와 같은 quantum state를 얻는다.
$\inner{\vec{v}, \vec{y}} \equiv V \mod 2^l$를 만족하는 $\vec{v}$는 subset sum 문제를 classical하게 풀어서 모든 solution을 구할 수 있다.(이 부분에서 kuperberg의 subexponential한 저장공간을 classical 연산으로 해결한다고 볼 수 있다.) 이는 brute-force 방법으로 $O(2^l)$만큼의 시간복잡도를 가진다. $V$ 값은 총 $2^l$개 이고, $\vec{v} \in \{0,1\}^{l+4}$의 값은 총 $2^{l+4}$개 이므로, 평균적인 해의 개수는 $m = 2^4$이다.
이 solution들을 $\vec{v}_1, … , \vec{v}_m \in \{0,1\}^{l+4}$라고 하자. 그러면 $\vec{v}_1, \vec{v}_2$로 span되는 subspace에 대한 projective measurement를 수행할 수 있다. basis $\vec{v}_1, … , \vec{v}_m$에 대해서 amplitude의 크기가 1로 같으므로, 원하는 state를 얻을 확률은 $\frac{2}{m} = \frac{2}{2^4} = \frac{1}{8}$이며, 아래와 같은 quantum state를 얻는다.
$\inner{(\vec{v}_2 - \vec{v}_1), \vec{y}} \equiv 0 \mod 2^l$이 보장되므로, 2-variation은 $l$ 이상인 새로운 labeled quantum state를 얻는다.
Time Complexity of Regev’s algorithm
$n = \ceil{\log N}$이라고 할 때, $l = O(\sqrt{n \log n})$으로 잡으면, $k = O(\sqrt{n/\log n})$에 대해 $lk = O(n)$만큼의 저장공간만 필요로 한다는 것을 알 수 있다. 이 때, classical한 연산의 시간복잡도는 $O(2^l) = 2^{O(\sqrt{n \log n})}$이다. 또한, 필요한 labeled quantum state의 수(=필요한 query의 수)는 $l^k = 2^{O(\sqrt{n \log n})}$이다. Kuperberg의 query 수랑 비교했을 때 약간 더 많음을 알 수 있다.
만약에 $l = n$으로 잡으면, $k = 1$이 되어, 필요한 query 개수는 $n$개가 된다. 이러면 polynomial query 안에 문제를 해결할 수 있게된다. 하지만 여기서 함정은 classical한 연산을 $O(2^n) = O(N)$만큼 해야한다는 점이다. 이는 단순히 Hidden Shift 문제를 classical하게 해결하는 것과 같다.
논문에서는 이 문제를 최적화된 classical 알고리즘을 적용해 $\tilde{O}(2^{0.291 \log_2(N)})$으로 해결함으로써 CSIDH-512가 NIST 기준에 맞지 않게됨을 보이고있다. 이 의미는 결국 Classical한 측면에서 Hidden Shift Problem을 Subset Sum Problem으로 quantum reduction시켰다는 것이다. Subset Sum에 대한 최적화된 해결방법이 있으므로 이를 통해 Hidden Shift Problem를 우회적으로 짧은 시간 안에 해결하게 된다.
CSIDH-512의 경우에 Class Group의 크기가 대략 $N \approx \sqrt{p} = 2^{256}$이며, $l = 256$에 대한 Regev algorithm을 적용하면 $2^{19}$만큼의 quantum query가 필요하며, $2^{86}$만큼의 classical time과 memory가 필요하다는 결론이 나온다.
Kuperberg’s second algorithm(Collimation Sieve)
이 알고리즘은 2010년도 Another subexp quantum algorithm for DHSP를 참조 이 알고리즘은 Collimation Sieve라고 불림(Collimation은 방향이 다른 빛을 평행하게 한방향으로 만들어주는 것이라고 함)
Kuperberg의 두번째 알고리즘도 여러 개의 labeled quantum state를 한번에 combination하는 방법을 사용한다. 다만 방식이 조금 다르다. labeled quantum state의 list를 만들어 list끼리 combination 해서 lsb를 지우는 방법을 사용한다. 이 알고리즘도 combination 과정에서 classical algorithm이 사용된다. 여기서는 subset sum 문제를 풀지 않고, 두 개의 list에서 matching을 찾는 문제를 풀어야한다. 이 또한 exponential 수준의 classical time을 필요로한다.
Collimation Sieve나 Regev의 알고리즘이나 중요한 철학은 classical 자원을 어떻게 최대한으로 이용해서 quantum space 또는 quantum time을 줄일 것이냐 하는 것이다. Regev의 알고리즘은 quantum space를 polynomial하게 줄였다.
Kuperberg가 Collimation Sieve를 제시하면서 주장하는 것은 classical 자원을 활용해서 quantum time도 polynomial하게 줄일 수 있다는 것이다. 물론 quantum space도 여전히 polynomial하게 유지할 수 있다.
그런데 여기서 개인적인 의문점은 앞서 설명한 것처럼 Regev의 알고리즘도 classical한 자원을 exponential하게 활용해서 quantum time을 polynomial하게 줄일 수 있음을 보였다. 따라서 Collimation Sieve가 Regev의 알고리즘보다 어떤 점이 더 좋은건지 아직은 이해가 잘 가지 않는다..
Collimation Sieve는 아래와 같은 list state를 사용한다.
list의 크기 $M$은 제한이 없으며, combination 과정을 거치기 전 초기 list state는 $M = 2^l$로 $l$개의 labeled state를 tensor product하여 아래와 같이 생성한다.
여기까지는 Regev의 알고리즘과 형태가 비슷하다. 하지만 이는 combination의 중간 결과물이 아니라 입력 또는 출력될 quantum state의 형태라는 것을 알아두길 바란다. list state $\sum_{i=0}^{M} \chi(\frac{y_i}{N})\ket{i}$의 height $h$는 모든 $0 \leq i < M$에 대해서 $y_i < 2^h$를 만족하는 가장 작은 $h$를 의미한다. 우리의 목표는 점점 작은 height을 가지는 list state를 만들어서 height가 1인 list state를 얻었을 때, shift 값 $s$의 한비트 정보를 담고있는 labeled state를 얻는 것이다.
Combination Step of Collimation Sieve(2-list merging)
height이 $h$로 같고, 사이즈도 $M$으로 같은 list state 두 개가 아래와 같이 주어졌다고 해보자.
$\ket{\psi_1} \propto \sum_{i=0}^{M-1} \chi(\frac{v_i}{N})\ket{i}$
이 둘을 tensor product하면 아래와 같이 합쳐진다.
여기서 Regev 알고리즘과 비슷하게 $\ket{i}\ket{j}\ket{0} \rightarrow \ket{i}\ket{j}\ket{\floor{(u_i + v_j)/{2^{(h-r)}}}}$ 연산을 적용하고 세번째 레지스터를 측정해서 label $V$와 아래와 같은 quantum state를 얻는다.
여기서 classical하게 $\floor{(u_i + v_j)/{2^r}} = V$를 만족하는 모든 $(u_i, v_j)$쌍을 찾는다. 이 과정은 $O(M)$만큼 걸린다. 찾은 쌍들의 개수가 총 $M’$개라고 할 때, 찾아놓은 모든 $(u_i, v_j)$ 값들을 이용해 $\ket{0}, …, \ket{M’-1}$로 basis를 변화시켜주면 아래와 같은 새로운 list state를 얻을 수 있다.
global phase는 무시되므로 새롭게 얻은 list state $\ket{\psi_{new}}$의 heigth은 $h-r$이 된다. 여기서 $r$값은 $\ket{\psi_{new}}$의 사이즈 $M’$에 따라 정해진다. $V$ 값의 경우의 수는 $2^r$개 이고, 좌변의 $(u_i, v_j)$ 쌍의 개수는 총 $M^2$개 이므로 평균적으로 해의 개수는 $M’ = \frac{M^2}{2^r}$이라고 할 수 있다. $M = 2^l$이라고 하면, $r = l$일 때, 새로 얻은 list state의 사이즈가 대략 $M’ = M$이 되도록 할 수 있다.
$r$이 커짐에 따라서 출력되는 list state의 사이즈는 exponential하게 줄어든다. 반대로 combination을 통해 더 많이 height을 줄이고 싶다면 입력으로 들어가는 list state의 사이즈는 exponential하게 커져야함을 알 수 있다.
$r$을 크게하고 싶어서 욕심을 부리다보면 출력 사이즈 $M’$가 점점 작아져 다음단계에 충분한 $r$을 뽑아내지 못한다. 따라서 적당한 크기의 $r$을 선택해서 출력 사이즈 $M’$이 점점 커지도록 하면 $r$도 커지고, $M’$도 커지면서 효과적으로 알고리즘을 수행할 수 있다. 따라서 논문에서는 $r = l-1$로 선택해서 $M’ = 2M$으로 출력 사이즈가 입력 사이즈의 두배가 되도록 만든다. 그러면 다음 단계에서는 $r$값도 1이 커지고, $M’$ 또한 계속 두배로 증가한다. Time complexity를 계산할 때 이 방법을 사용하도록 하겠다.
해당 combination은 두 개의 list state만을 입력으로 받지만, Kuperberg 논문을 보면 여러개의 list state를 한 번에 합치는 방법도 사용한다. 하지만 해당 포스트에서는 Quantum Security Analysis of CSIDH논문에서 고려한 2-list merging 방법만을 고려하도록 하겠다.
Time Complexity and Tradeoffs
앞서 설명한 2-list merging을 사용해서 원하는 labeled state를 얻으려면 binary tree 구조로 combination을 수행해야한다. binary tree의 depth에 따라서 전체 time complexity, memory complexity 등이 결정될 것이다. 우리가 원하는 것은 height이 1인 list state이므로 time complexity $2^t$, quantum memory complexity $2^m$, quantum query $2^q$에 대한 아래와 같은 그래프를 그릴 수 있다.
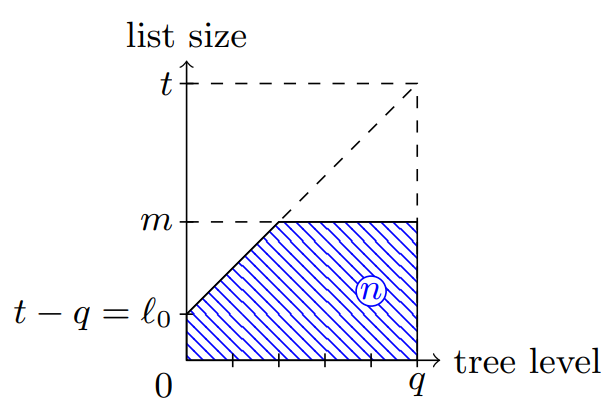
그래프에서 tree level이 0일 때 초기 list state의 사이즈 $2^{l_0}$를 $m$으로 최대한 키울 수 없는 이유는 tree level 0에서는 leaf node의 개수가 총 $2^q$개인데, 2-list merging은 $O(2^{l_0})$만큼의 시간복잡도를 가지므로 level 0에서만 총 $O(2^{l_0 \cdot q})$만큼의 시간복잡도를 소모하기 때문이다. 앞서 시간복잡도는 $2^t$라는 설정이 있었으므로 $l_0 = t-q$가 최대 사이즈가 된다.
2-list merging을 수행할 때마다 list state의 사이즈에 log scale만큼 height가 줄어들기 때문에 각 tree level에서 줄어든 height을 모두 합하면(위 그래프에서 색칠한 부분) 아래와 같은 식을 만족해야함을 알 수 있다.
여기서 $t=q=m$을 적용하면 모든 complexity가 subexponential인 $\tilde{O}(2^{\sqrt{2n}})$가 됨을 알 수 있다. 논문에서 자세히 나오진 않았지만, 원래 Kuperberg가 주장했던 바에 의하면 quantum memory $2^m$은 polynomial하게 낮출 수 있어야한다. 아마 위의 식에서 $m$이 상수라고 생각하면 되는게 아닐까 생각해본다..